Blog

  • Bester Markdown-Table-Generator: Excel, CSV und JSON schnell in GFM umwandeln

    Bester Markdown-Table-Generator: Excel, CSV und JSON schnell in GFM umwandeln

    Sie mĂŒssen eine Tabelle, eine CSV- oder eine JSON-Datei in eine saubere Markdown-Tabelle umwandeln? Im Jahr 2026 ist der Prozess unkompliziert – das richtige Werkzeug hĂ€ngt davon ab, ob Sie eine einmalige Konvertierung durchfĂŒhren oder Dokumentation im großen Maßstab automatisieren.

    Dieser Leitfaden stellt die besten Werkzeuge fĂŒr jedes Szenario vor: visuelle Editoren fĂŒr manuelle Arbeiten, CLI-Tools fĂŒr die Automatisierung und CI/CD-Integration, um Dokumentation mit Ihrer Codebasis synchron zu halten.

    Die besten Tools auf einen Blick

    Tool Am besten fĂŒr Typ StĂ€rke
    TableGenerator.com Schnelle visuelle Bearbeitung Web (clientseitig) Grid-basierter Editor, Ausrichtungs­kontrolle
    AnywayData UnĂŒbersichtliche JSON-Dateien Web / Bibliothek Einebnung verschachtelter Strukturen, AST-Parsing
    MarkItDown (Microsoft) Excel-/Word-Automatisierung Python-CLI BehÀlt Kopfzeilen und Tabellengitter aus Office-Dateien
    Pandoc Multiformat-Konvertierung CLI UnterstĂŒtzt Dutzende Formate, stabil im großen Maßstab
    EaseCloud Excel → GFM Web Einfacher browserbasierter Konverter
    GoConverter Excel → GFM Web Schnelle Konvertierung mit Ausrichtungsoptionen

    Laut DasRoot (2026) können moderne Markdown-Tools mittelgroße DatensĂ€tze mit 15–30 Tabellen pro Sekunde verarbeiten – und die besten davon nutzen clientseitige Verarbeitung, wodurch Ihre Daten niemals den Browser verlassen.

    Warum GFM-KonformitÀt wichtig ist

    GitHub Flavored Markdown (GFM) ist der spezifische Dialekt, der von GitHub, GitLab und Discord verwendet wird. Die ursprĂŒngliche Markdown-Spezifikation unterstĂŒtzte gar keine Tabellen – GFM fĂŒgte die vertraute „Pipe-und-Strich“-Syntax hinzu. Ein GFM-konformer Generator stellt sicher, dass Ihre Tabellen mit fetten Kopfzeilen und ausgerichteten Spalten korrekt gerendert werden, anstatt als reiner Text zu erscheinen.
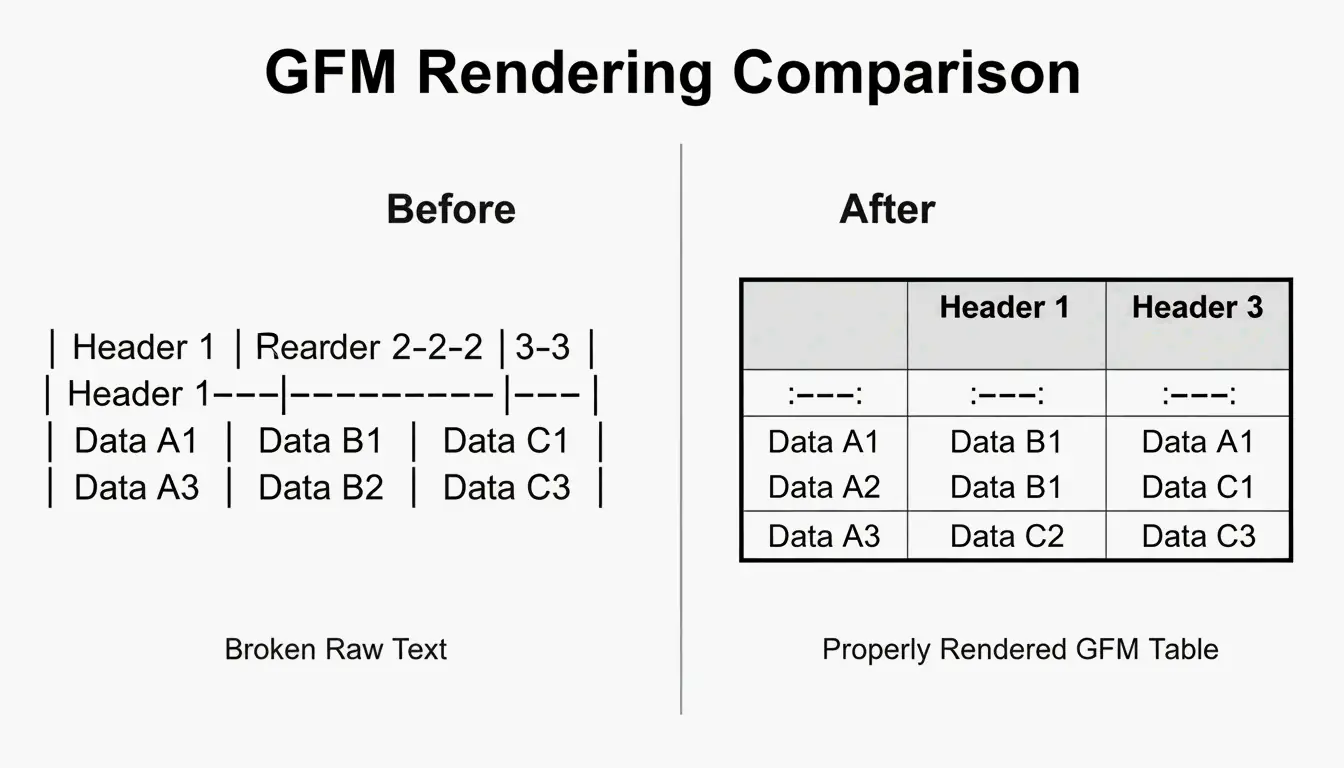
    Visueller Vergleich zwischen Rohdaten und einer gerenderten GFM-Tabelle

    So konvertieren Sie Excel und CSV in GFM

    Der Vorgang besteht aus zwei Schritten:

    1. Als CSV exportieren – Speichern Sie Ihre Excel- oder Google-Sheets-Datei als CSV. Das entfernt aufwendige Formatierung, behĂ€lt aber das Datenraster bei.
    2. Konvertieren – Nutzen Sie ein browserbasiertes Tool wie EaseCloud oder GoConverter, um GFM-Code zu erzeugen.

    Spaltenausrichtung

    GFM steuert die Ausrichtung ĂŒber die Trennzeile (die Zeile unter der Kopfzeile):

    Syntax Ausrichtung
    :--- LinksbĂŒndig (Standard)
    ---: RechtsbĂŒndig
    :---: Zentriert

    Pipe-Zeichen maskieren

    Markdown verwendet |, um SpaltenrÀnder zu markieren. Enthalten Ihre Daten ein Pipe (etwa in einem Code-Snippet oder einer Formel), wird die Tabelle zerstört. Maskieren Sie es mit:

    • HTML-Entity: |
    • Backslash: \|
    • Code-Backticks: |

    Große DatensĂ€tze verarbeiten (100+ rows)

    Bei DatensĂ€tzen mit mehr als 100 Zeilen können webbasierte visuelle Editoren ins Stocken geraten. Moderne Konverter nutzen inkrementelles Parsing, um reaktionsschnell zu bleiben. Laut AnywayData lĂ€sst sich mit „paarweiser kombinatorsicher Datenlogik“ die Anzahl notwendiger TestfĂ€lle um 90–99% reduzieren – was besonders beim Dokumentieren komplexer Konfigurationen hilft.

    FĂŒr wirklich große DatensĂ€tze sollten Sie erwĂ€gen, sie in mehrere Tabellen aufzuteilen oder neben der Markdown-Version einen Download-Link fĂŒr die CSV bereitzustellen.

    JSON in GFM umwandeln: Verschachtelte Daten einebnen

    JSON ist hierarchisch aufgebaut – Daten sind wie russische Matrjoschka-Puppen ineinander geschachtelt. Markdown-Tabellen sind flache 2D-Raster. Die Konvertierung erfordert Einebnungslogik:

    user.address.city  →  "User Address City" (single column header)
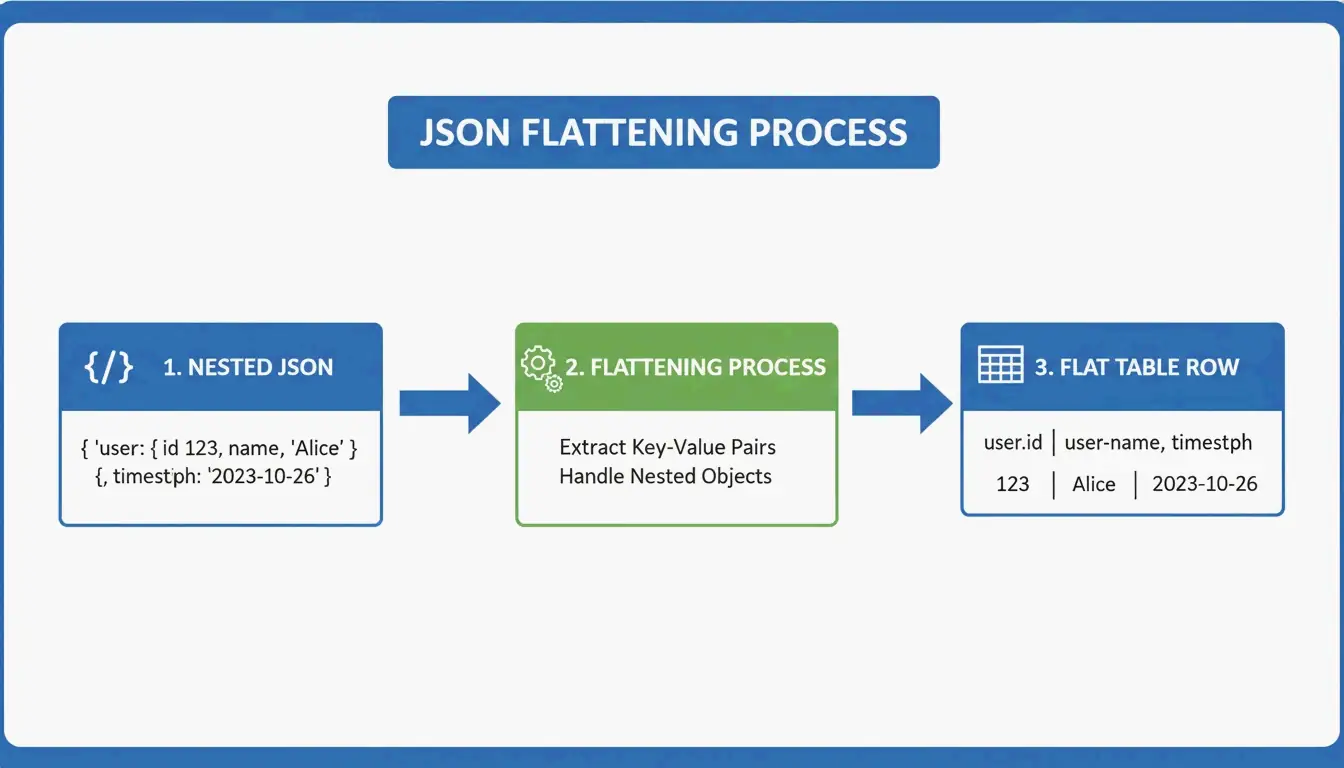
    

    Dreistufige Visualisierung: verschachteltes JSON wird zu einer flachen Tabellenzeile eingeebnet

    AnywayDatas Grid Table Editor glĂ€nzt hier – er erlaubt den Import von JSON und die manuelle Kontrolle darĂŒber, wie verschachtelte Ebenen eingeebnet werden. Die QualitĂ€t der Konvertierung hĂ€ngt davon ab, ob das Werkzeug auf der Konstruktion eines AST (Abstract Syntax Tree) basiert statt auf einfacher Textmuster-Erkennung. AST-basierte Parser bauen eine logische Karte der Datenstruktur auf und gehen damit mit deutlich höherer Genauigkeit auf tiefe Verschachtelungen und inkonsistente Schemata ein.

    Automatisierung mit CI/CD

    FĂŒr Engineering-Teams ist manuelle Konvertierung Zeitverschwendung. Die Integration der Tabellenerzeugung in Ihre CI/CD-Pipeline stellt sicher, dass README-Dateien automatisch aktuell bleiben:

    • Wandeln Sie JSON-API-Antworten wĂ€hrend des Build-Prozesses in GFM um
    • Behandeln Sie Dokumentation als Code – sie wird aktualisiert, sobald sich Ihre Daten Ă€ndern
    • Verhindern Sie das weit verbreitete Problem veralteter oder fehlerhafter Informationen in Ihrem Repo

    Tools wie Terraform-docs v0.17.0 (2026) injizieren Ressourcentabellen automatisch direkt in README-Dateien – ein Beleg dafĂŒr, dass CLI-Tools bei Infrastruktur-Dokumentation Web-OberflĂ€chen oft ĂŒberlegen sind.

    MarkItDown vs. Pandoc: Welches sollten Sie verwenden?

    Faktor MarkItDown (Microsoft) Pandoc
    Optimiert fĂŒr Office-Dateien (Excel, Word) Universelle Dokumentkonvertierung
    Markdown-Varianten GFM-fokussiert CommonMark, GFM und viele weitere
    Am besten fĂŒr Schnelles XLSX → GitHub-Tabelle Multiformat-CLI-Arbeit in großen Mengen
    Aktuelle Version 2026 3.9.0.2 (stabil)
    Geschwindigkeit Schneller fĂŒr einzelne Office-Dateien Besser fĂŒr Stapelverarbeitung
    Verwenden, wenn Sie eine Excel-Datei konvertieren mĂŒssen Sie zwischen Dutzenden Formaten konvertieren mĂŒssen

    FĂŒr die meisten Entwickler ist MarkItDown im hĂ€ufigsten Fall (Excel → GitHub-Tabelle) schneller. Pandoc ist die bessere Wahl, wenn Sie viele Dokumentformate jonglieren oder umfangreiche Stapelkonvertierungen durchfĂŒhren.

    Fazit

    Die Konvertierung von Daten in GFM-Tabellen im Jahr 2026 lÀuft auf Volumen und Workflow hinaus:

    • Einmalige Bearbeitungen → TableGenerator.com oder AnywayData fĂŒr visuelle Kontrolle
    • Wiederkehrende Office-Konvertierungen → MarkItDown, integriert in Ihren Python-Workflow
    • Multiformat oder hohes Volumen → Pandoc fĂŒr CLI-Stapelverarbeitung
    • Infrastruktur-Dokumentation → CI/CD-Automatisierung mit terraform-docs oder eigenen Skripten

    Das entscheidende Prinzip: Dokumentation sollte sich aktualisieren, wenn sich Ihre Daten aktualisieren. Eine automatisierte Konvertierung verhindert veraltete Tabellen und hÀlt die Dokumentation Ihres Projekts verlÀsslich.

    FAQ

    Wie maskiere ich Pipe-Zeichen (|) innerhalb einer Markdown-Tabellenzelle?

    Verwenden Sie das HTML-Entity | anstelle des literalen Pipes. Alternativ nutzen Sie einen Backslash-Escape \|, sofern Ihr GFM-Parser das unterstĂŒtzt, oder fassen Sie den Inhalt in Code-Backticks ein. Alle drei Methoden verhindern, dass das Pipe als Spaltentrenner interpretiert wird.

    UnterstĂŒtzt GFM verbundene Zellen oder mehrzeilige Inhalte?

    Nein. Standard-GFM unterstĂŒtzt weder colspan noch rowspan. Jede Zelle muss eigenstĂ€ndig sein. FĂŒr mehrzeilige Inhalte innerhalb einer Zelle verwenden Sie HTML-<br>-Tags, um ZeilenumbrĂŒche zu erzwingen und die Daten dennoch in einer einzelnen Zeile zu halten.

    Was ist der beste Ansatz fĂŒr DatensĂ€tze mit mehr als 100 Zeilen?

    Lassen Sie webbasierte visuelle Editoren links liegen (sie werden ruckeln). Nutzen Sie stattdessen CLI-Tools wie MarkItDown oder Pandoc. Falls die resultierende Tabelle zu groß fĂŒr eine einzelne Seite ist, splitten Sie sie in mehrere Tabellen auf oder stellen Sie einen Link zu einer herunterladbaren CSV-Datei bereit, um die Lesbarkeit zu wahren.
  • EAN-13 vs. EAN-8: Welches Barcode-Format passt zu Ihrem Produkt?

    EAN-13 vs. EAN-8: Welches Barcode-Format passt zu Ihrem Produkt?

    Nehmen Sie ein beliebiges Produkt im Handel in die Hand, und irgendwo auf der Verpackung finden Sie einen Barcode. Meistens handelt es sich um einen EAN-13 – 13 Ziffern, gestreckt ĂŒber das vertraute Band aus schwarzen und weißen Strichen. Gelegentlich aber, bei etwas Kleinem wie einer Kaugummipackung oder einem Lippenstift, entdecken Sie einen kĂŒrzeren, kompakteren Code: den EAN-8.

    Beide Formate erfĂŒllen dieselbe Aufgabe – sie geben jedem Produkt eine eindeutige, scannbare ID – sind aber fĂŒr unterschiedliche Einsatzzwecke konstruiert. Dieser Leitfaden erklĂ€rt die wesentlichen Unterschiede zwischen EAN-13 und EAN-8, wann welches Format die richtige Wahl ist und wie sie in das umfassendere GS1-Barcodesystem eingebettet sind.

    EAN-13 vs. EAN-8: Die wichtigsten Unterschiede auf einen Blick

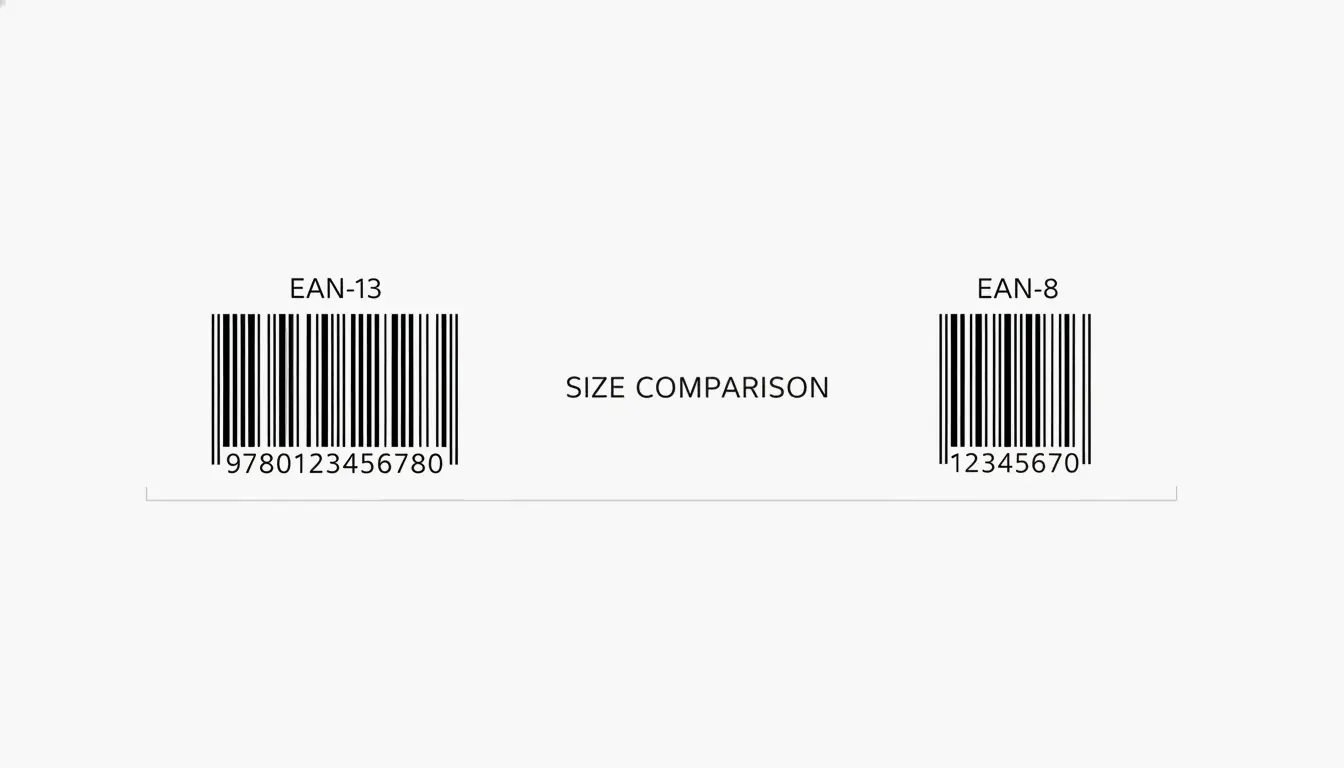
    Der grĂ¶ĂŸte Unterschied zwischen den beiden Formaten lĂ€sst sich auf zwei Punkte reduzieren: wie viele Ziffern sie tragen und wie viel Platz sie auf dem Etikett einnehmen.

    Merkmal EAN-13 EAN-8
    Ziffern 13 8
    Modulbreite 95 Module 67 Module
    Minimale Druckbreite ~1,5 Zoll (38 mm) ~1 Zoll (26 mm)
    Typischer Einsatz Standard-Handelsprodukte Sehr kleine Verpackungen
    Verwaltet von GS1 GS1

    Ein EAN-13-Barcode kodiert 13 Ziffern und besteht aus 95 gleich breiten Modulen, laut Wikipedia. EAN-8 kodiert nur 8 Ziffern, wodurch ein deutlich schmalerer Barcode entsteht – etwa zwei Drittel so breit.

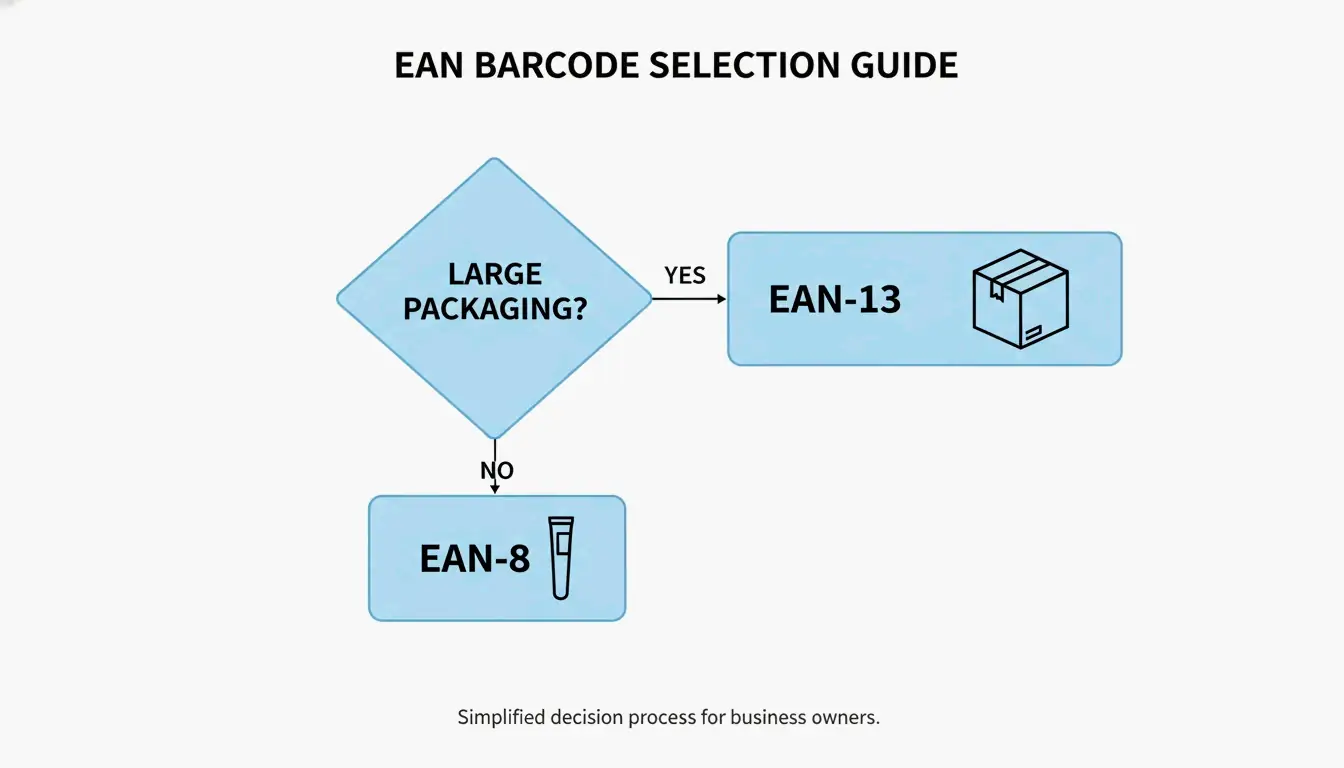
    Die Wahl treffen: Ein einfacher Entscheidungsbaum

    Wer sich fĂŒr ein Format entscheiden muss, folgt einer einfachen Logik:

    1. Standardprodukte – Wenn Ihre Verpackung Platz fĂŒr einen mindestens 1,5 Zoll breiten Barcode bietet, wĂ€hlen Sie EAN-13. Das ist weltweiter Standard im Einzelhandel.
    2. Kleine Artikel – Ist der Druckbereich auf Ihrem Produkt zu knapp fĂŒr EAN-13, können Sie ein EAN-8 beantragen.

    Ein einfacher 2-stufiger Entscheidungsbaum: Ist die Verpackung klein? Nein -> EAN-13; Ja -> EAN-8.

    HĂ€ufig ĂŒbersehen wird die sogenannte Quiet Zone – der leere weiße Bereich auf beiden Seiten des Barcodes. Laut Wikipedia enthalten EAN-13-Barcodes oft einen >-Indikator auf der rechten Seite, der markiert, wo die Quiet Zone beginnt. Dieses visuelle Zeichen hilft Scannern, die RĂ€nder des Codes zu finden, ohne sich von benachbarten Grafiken oder Texten irritieren zu lassen.

    Wann EAN-8 die richtige Wahl ist: Die FlÀchenregel

    EAN-8 ist keine kostenlose Alternative – es ist ein Spezialformat fĂŒr Produkte, auf die tatsĂ€chlich kein Standardbarcode passt. Wie Barcodes South Africa erklĂ€rt, können GS1-Mitgliedsorganisationen EAN-8-Nummern nur an Hersteller vergeben, die nachweisen, dass ihre Verpackung zu klein fĂŒr EAN-13 ist, da mit nur 8 Ziffern (weit weniger eindeutige Kombinationen als bei 13) deutlich weniger Nummern zur VerfĂŒgung stehen.

    In der Praxis finden Sie EAN-8 daher auf Artikeln wie:
    – Einzelne Schokoriegel oder Kaugummipackungen
    – Kleine Kosmetikartikel (Lippenbalsam, Mascara)
    – Saatgut- oder GewĂŒrztĂŒtchen
    – Winzige Elektronikzubehörteile

    Wenn Ihr Produkt ausreichend Platz bietet, ist EAN-13 immer die Standardwahl.

    Technische Spezifikationen: Wie sind EAN-Formate aufgebaut?

    Hinter den Strichen folgen die EAN-Formate einem prĂ€zisen Aufbau, der jedes Produkt ĂŒber das GS1-System (Global Standards 1) weltweit eindeutig identifiziert.

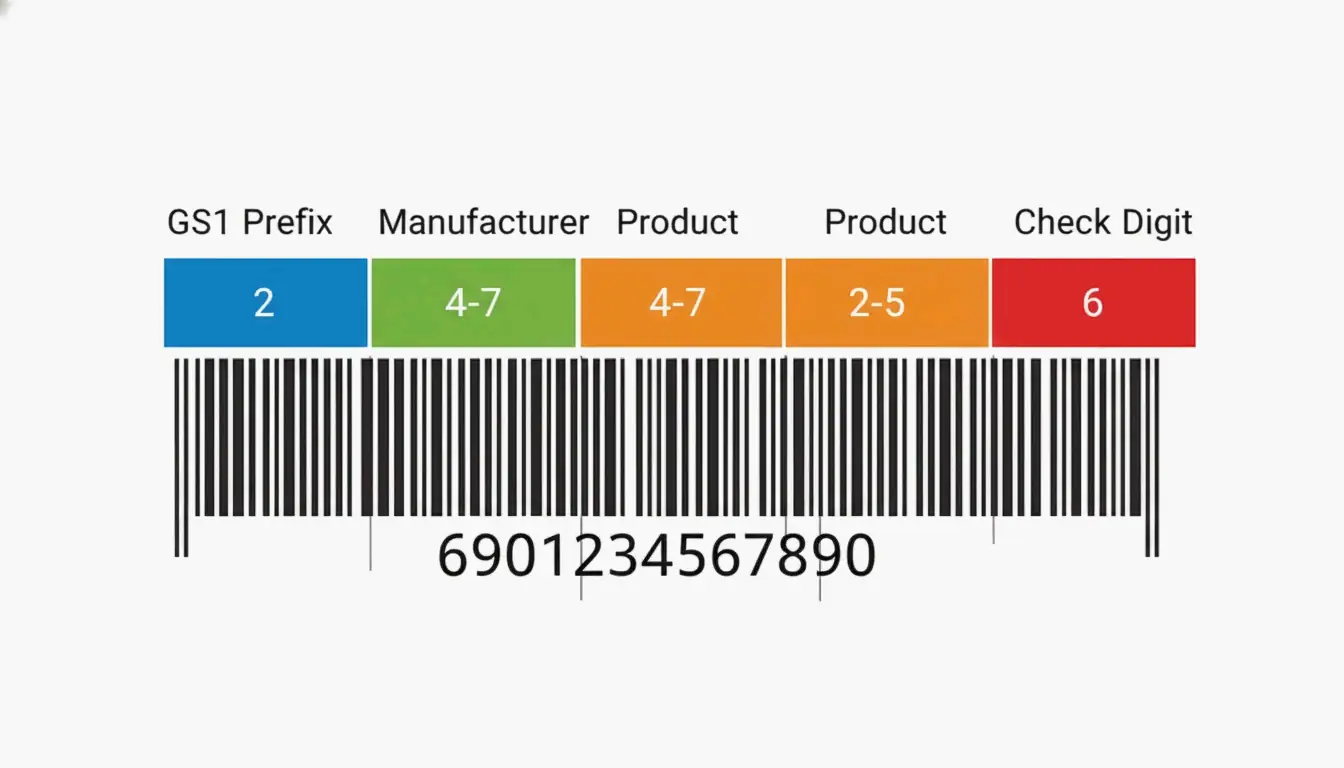
    Aufbau des EAN-13:

    • GS1-PrĂ€fix (3 Ziffern): Gibt an, welche GS1-Mitgliedsorganisation den Code ausgegeben hat. Zum Beispiel steht 590 fĂŒr Polen, 400–440 fĂŒr Deutschland.
    • Herstellercode (variable LĂ€nge): Die einem Unternehmen zugewiesene eindeutige Kennung.
    • Produktcode (variable LĂ€nge): Die Nummer, die das Unternehmen einem bestimmten Artikel zuweist (im Wesentlichen die SKU).
    • PrĂŒfziffer (1 Ziffer): Die letzte Ziffer, die aus allen vorherigen Ziffern berechnet wird, um Scanfehler zu erkennen.

    Aufbau des EAN-8:

    EAN-8 funktioniert anders – es gibt keinen variablen Herstellercode. Die Nummerierungsstelle vergibt Produktcodes direkt. Laut Oracle kann jedes Unternehmen ein EAN-8 beantragen, selbst wenn es bereits ein EAN-13-PrĂ€fix besitzt, doch zwischen den beiden Nummern besteht kein mathematischer Zusammenhang.

    Eine visuelle AufschlĂŒsselung der EAN-13-Komponenten mit farbcodierten Segmenten.

    Beide Formate sind beim Erkennen von Fehlern bemerkenswert zuverlĂ€ssig. Wikipedia merkt an, dass EAN-13 100 % der einstelligen Fehler und 90 % der Vertauschungsfehler (zwei benachbarte Ziffern werden vertauscht) erkennt. Das heißt: Wenn ein Scanner auch nur einen Strich falsch liest, wird die PrĂŒfziffer dies fast immer melden.

    Wird EAN-13 in den USA akzeptiert? Vergleich mit UPC-A

    Eine hÀufige Sorge international tÀtiger Unternehmen ist, ob EAN-13 in den Vereinigten Staaten funktioniert, die historisch ihr eigenes 12-stelliges UPC-A-Format verwendeten.

    Die kurze Antwort: ja, vollstĂ€ndig. Die Initiative „2005 Sunrise“ – mittlerweile langjĂ€hrige Praxis – verpflichtet jedes Kassensystem in den USA und Kanada, sowohl EAN-13 als auch UPC-A zu akzeptieren. TatsĂ€chlich ist EAN-13 technisch eine Erweiterung von UPC-A. Ein UPC-A-Barcode ist schlicht ein EAN-13, bei dem die erste Ziffer 0 ist.

    Was das in der Praxis bedeutet:
    – Als globale Marke können Sie EAN-13 ĂŒberall einsetzen – ohne separate UPC-A-Codes.
    – Amerikanische HĂ€ndler können Ihre EAN-13-Produkte ohne KonfigurationsĂ€nderungen scannen.

    Im EAN-13-System gibt es zudem spezielle PrĂ€fixe, die man kennen sollte. Die Bookland-PrĂ€fixe (978 und 979) betten ISBNs direkt in den EAN-13 ein, sodass BĂŒcher an jeder Standard-Checkout-Kasse gescannt werden können, unabhĂ€ngig davon, wo sie veröffentlicht wurden.

    GTIN-Integration und Datenbank-Normalisierung

    Sowohl EAN-13 als auch EAN-8 gehören zur Familie der Global Trade Item Number (GTIN). Wenn Produkte mit unterschiedlich langen Barcodes in derselben Datenbank landen – etwa in einem Lagerverwaltungssystem –, brauchen sie ein einheitliches Format. Hier kommt GTIN-14 ins Spiel.

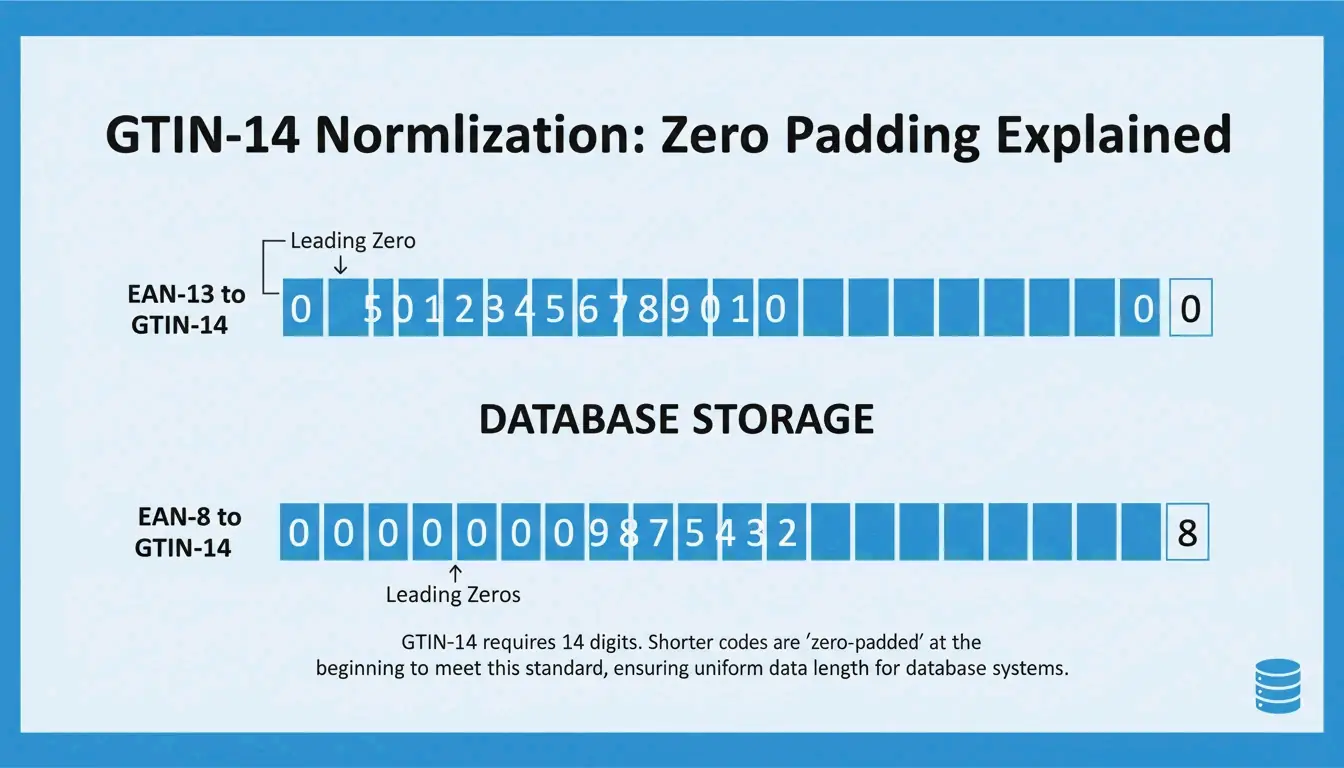
    Die Normalisierung ist einfach: KĂŒrzere Codes werden mit fĂŒhrenden Nullen aufgefĂŒllt.

    Barcode GTIN-14
    EAN-13: 4006381333931 04006381333931 (1 fĂŒhrende Null)
    EAN-8: 96385074 00000096385074 (6 fĂŒhrende Nullen)

    In Systemen wie Oracle WMS werden alle GTINs rechtsbĂŒndig ausgerichtet und auf 14 Ziffern aufgefĂŒllt, sodass ein einziges Datenbankfeld alles abdecken kann – von der Lippenbalsamtube bis zur vollen Palette.

    Eine einfache Visualisierung der „Zero Padding"-AuffĂŒllung, um EAN-8 und EAN-13 in GTIN-14-Blöcke auszurichten.

    So wird die PrĂŒfziffer berechnet (Modulo-10, Schritt fĂŒr Schritt)

    Die letzte Ziffer eines EAN-Barcodes ist nicht zufĂ€llig – sie wird mit dem Modulo-10-Algorithmus berechnet. Moderne Software erledigt das automatisch, doch die Mathematik zu verstehen ist nĂŒtzlich, wenn Sie Barcodes programmgesteuert erzeugen oder ein Scanproblem analysieren.

    Beispiel: PrĂŒfziffer fĂŒr EAN-13400638133393? verifizieren

    Schritt 1 – Von rechts (ohne die PrĂŒfziffer) abwechselnd die Gewichte 3 und 1 zuweisen:

    Position 12 11 10 9 8 7 6 5 4 3 2 1
    Ziffer 4 0 0 6 3 8 1 3 3 3 9 3
    Gewicht 1 3 1 3 1 3 1 3 1 3 1 3
    Produkt 4 0 0 18 3 24 1 9 3 9 9 9

    Schritt 2 – Alle Produkte addieren: 4 + 0 + 0 + 18 + 3 + 24 + 1 + 9 + 3 + 9 + 9 + 9 = 89

    Schritt 3 – Das nĂ€chste Vielfache von 10 finden (das ist 90). Subtrahieren: 90 − 89 = 1.

    Die PrĂŒfziffer ist 1, womit der vollstĂ€ndige Barcode 4006381333931 lautet.

    Diese Probe ist beim Etikettendesign ein sinnvoller Sanity-Check – eine falsche PrĂŒfziffer zu erkennen, bevor Tausende Etiketten gedruckt sind, spart Geld und Zeit.

    Fazit

    EAN-13 ist das globale Arbeitspferd der Barcodierung im Einzelhandel – es kommt bei der ĂŒberwiegenden Mehrheit der Produkte zum Einsatz. EAN-8 ist die kompakte Alternative, reserviert fĂŒr Artikel, deren Verpackung zu klein fĂŒr einen Standardbarcode ist. Beide Formate werden von GS1 verwaltet, beide nutzen dasselbe Modulo-10-PrĂŒfziffersystem, und beide werden von jedem modernen POS-System weltweit zuverlĂ€ssig gelesen – auch in den USA und Kanada.

    Die Entscheidung fĂ€llt auf die verfĂŒgbare FlĂ€che. Wenn Ihre Verpackung einen mindestens 1,5 Zoll breiten Barcode aufnehmen kann, verwenden Sie EAN-13. Ist das nicht möglich, beantragen Sie ĂŒber Ihr lokales GS1-BĂŒro ein EAN-8. In beiden FĂ€llen wird Ihr Produkt in der gesamten Lieferkette korrekt gescannt.

    FAQ

    Kann ich einen EAN-8-Code in einen EAN-13-Code umwandeln?

    Nein – es handelt sich um völlig getrennte Kennungen. EAN-8-Nummern werden direkt von GS1 vergeben und haben keine Verbindung zu Ihrem EAN-13-HerstellerprĂ€fix. Wenn Sie einen EAN-13-Code benötigen, mĂŒssen Sie eine Nummer aus Ihrem zugewiesenen EAN-13-Block verwenden.

    Wird EAN-13 in den USA und Kanada akzeptiert?

    Ja. Seit dem 2005 Sunrise-Abkommen liest jedes moderne POS-System in Nordamerika sowohl UPC-A als auch EAN-13 problemlos. Die meisten globalen Marken nutzen mittlerweile ausschließlich EAN-13, um die AblĂ€ufe ĂŒber alle MĂ€rkte hinweg einfach zu halten.

    Was passiert, wenn ich einen EAN-8-Barcode in einem System scanne, das 14 Ziffern erwartet?

    Das System fĂŒllt den 8-stelligen Code durch sechs fĂŒhrende Nullen auf (Zero-Padding), um das GTIN-14-Feld zu fĂŒllen (z. B. 000000XXXXXXXX). Das ist in Systemen wie Oracle WMS gĂ€ngige Praxis, um die DatenbankeintrĂ€ge ĂŒber verschiedene ProduktgrĂ¶ĂŸen hinweg konsistent zu halten.

  • Code 128 vs. Code 39: Barcode-Unterschiede einfach erklĂ€rt (2026)

    Code 128 vs. Code 39: Barcode-Unterschiede einfach erklÀrt (2026)

    Wer mit Barcodes arbeitet – egal ob in Logistik, Gesundheitswesen, Fertigung oder im Einzelhandel –, der ist vermutlich schon auf sowohl Code 128 als auch Code 39 gestoßen. Beide gehören zu den am weitesten verbreiteten 1D-Barcode-Formaten, und 2026 lautet die Entscheidung im Wesentlichen: Wie viele Daten mĂŒssen codiert werden, und wie viel Platz steht auf dem Etikett zur VerfĂŒgung?

    Code 128 ist der moderne Standard: hohe Dichte, voller ASCII-Support und eine zwingend erforderliche PrĂŒfziffer. Code 39 ist die Ă€ltere, einfachere Alternative, die fĂŒr kurze Zeichenketten gut funktioniert, bei lĂ€ngeren Daten aber unhandlich wird. Dieser Leitfaden erklĂ€rt die Unterschiede und hilft bei der richtigen Wahl.

    Code 128 vs. Code 39 auf einen Blick

    Merkmal Code 128 Code 39
    Datendichte Hoch – mehr Daten auf weniger Platz Niedrig – wird schnell breit
    Zeichensatz Alle 128 ASCII-Zeichen 43 Zeichen (Großbuchstaben, Ziffern, wenige Symbole)
    Kleinbuchstaben-UnterstĂŒtzung Nativ Nur ĂŒber „Extended“-Modus (verdoppelt die Barcode-LĂ€nge)
    PrĂŒfziffer Zwingend (Modulo 103) Optional
    Balken-/LĂŒckenbreiten 4 Breiten (1, 2, 3, 4 Einheiten) 2 Breiten (schmal und breit)
    Am besten geeignet fĂŒr Logistik, Versand, komplexe Daten Einfaches internes Tracking, Altsysteme

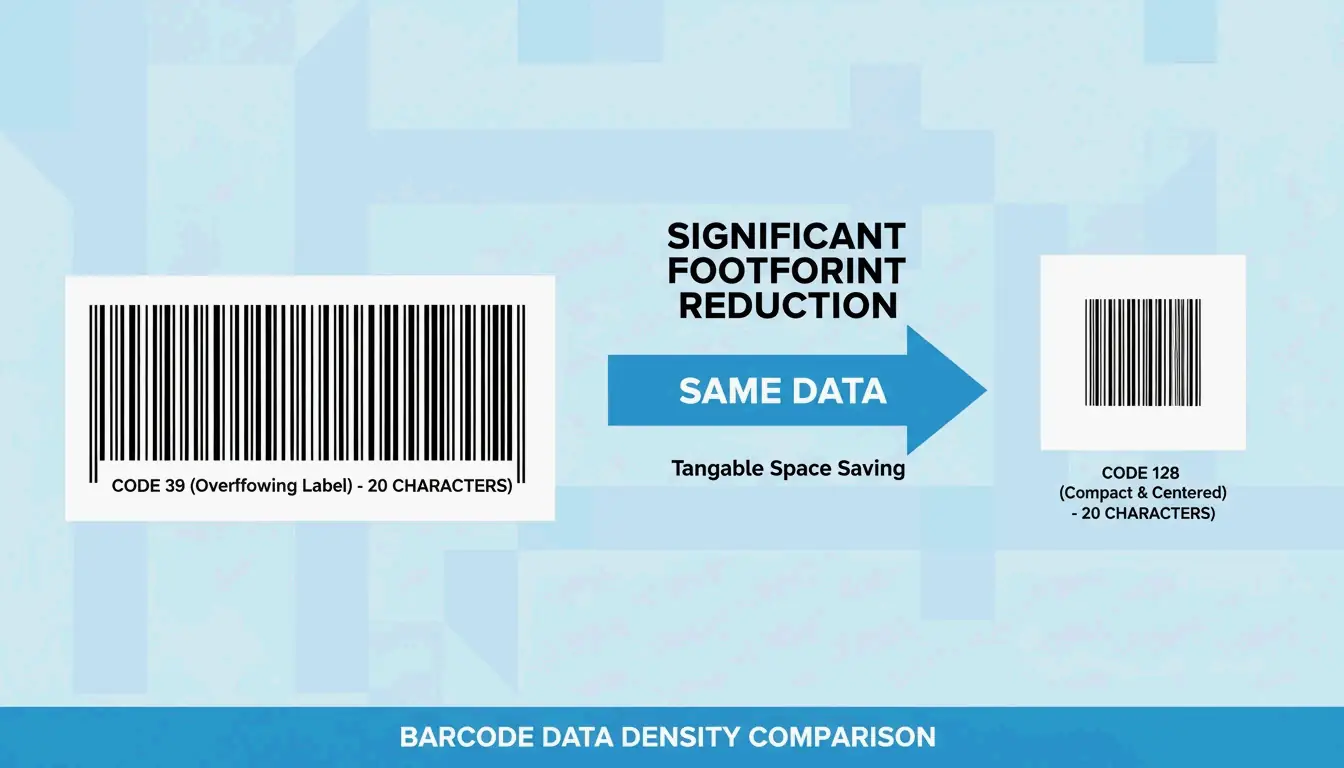
    Der Unterschied beim Platzbedarf ist betrÀchtlich. Laut Peak Technologies sollte man von Code 39 auf Code 128 wechseln, sobald die Datenzeichenkette lÀnger als 15 Zeichen ist. Eine 20-stellige ID in Code 39 passt unter UmstÀnden nicht mehr auf ein Standard-Etikett von 2 Zoll, wÀhrend Code 128 sie kompakt hÀlt.

    Direkter GrĂ¶ĂŸenvergleich: Code 128 ist bei denselben Daten deutlich kĂŒrzer als Code 39

    Moderne Scanner (FlĂ€chen-Imager und Smartphone-Apps) lesen beide Formate mĂŒhelos. Code 128 ist jedoch zuverlĂ€ssiger, da die integrierte Fehlererkennung Fehllesungen in Umgebungen mit hohem Durchsatz verhindert.

    Datendichte: Warum sie wichtig ist

    Datendichte bezeichnet die Anzahl der Zeichen, die in einem Zoll Barcode untergebracht werden. Wikipedia erklĂ€rt, dass Code 128 vier verschiedene Breiten fĂŒr Balken und LĂŒcken verwendet, wĂ€hrend Code 39 nur zwei nutzt. Diese PrĂ€zision macht Code 128 bei numerischen Daten etwa doppelt so dicht – oft bleibt es der einzige 1D-Barcode, der fĂŒr winzige Objekte wie MedikamentenflĂ€schchen oder kleine Elektronikbauteile funktioniert.

    Zeichen-UnterstĂŒtzung

    • Code 39 (Standard): 43 Zeichen – Großbuchstaben A–Z, Ziffern 0–9 und eine Handvoll Symbole (-, ., $, /, +, %, Leerzeichen).
    • Code 128: Alle 128 ASCII-Zeichen – Groß- und Kleinbuchstaben, Symbole und sogar Steuerzeichen wie WagenrĂŒcklauf.
    • Code 39 Extended: Kann Kleinbuchstaben ĂŒber Zeichenpaare codieren (z. B. „+A“ fĂŒr Kleinbuchstabe „a“), aber wie Peak Technologies anmerkt, ist das „verschwenderisch mit Platz“ und macht den Barcode unnötig lang.

    Warum Code 128 der moderne Logistik-Standard ist

    Code 128 treibt den weltweiten Versand ĂŒber den GS1-128-Standard an, der sogenannte „Application Identifiers“ nutzt, um Daten wie Chargennummern, Ablaufdaten und Seriennummern zu strukturieren.

    Zwingende PrĂŒfziffer (Modulo 103)

    Bei Code 39 ist eine PrĂŒfsumme optional. Bei Code 128 ist sie eingebaut – der Barcode hĂ€ngt einen berechneten Wert an, den der Scanner bei jedem Lesevorgang verifiziert. Das schließt das Risiko eines „falschen“ Scans in stark frequentierten Lagern praktisch aus.

    Optimierung durch die Code-Sets A, B und C

    Code 128 bleibt kompakt, indem es zwischen drei internen Modi wechselt:

    Code-Set Optimiert fĂŒr Hauptvorteil
    A Großbuchstaben + Steuerzeichen Industrielle Anwendungen
    B Standard alphanumerisch + Kleinbuchstaben Allgemeiner Text
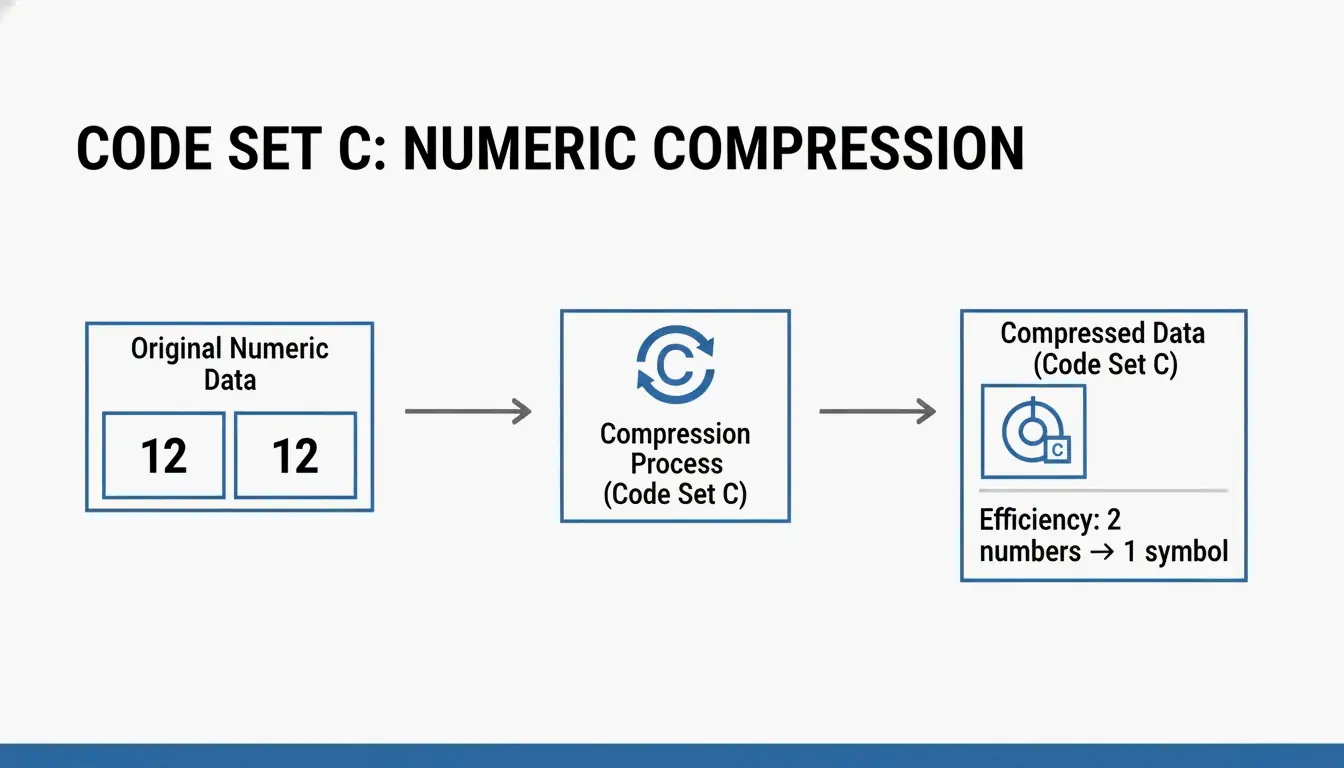
    C Ausschließlich numerische Daten Zwei Ziffern pro Symbol – am effizientesten fĂŒr Zahlen

    Wikipedia erklĂ€rt, dass Code-Set C zwei Ziffern in einem einzigen Barcode-Symbol unterbringt. Bei langen numerischen Zeichenketten ist das Ă€ußerst effizient. Untersuchungen von Steven Skiena zeigen, dass eine kluge Wahl des Code-Sets einen Barcode im Durchschnitt um 8 % verkleinern kann, verglichen mit einer statischen Einstellung.

    Einfache Darstellung, wie Code-Set C zwei Ziffern in einem Symbol paart

    Ist Code 39 noch relevant?

    Code 39 hat auch 2026 noch seine Daseinsberechtigung, weil es einfach und tolerant ist. Es ist „selbstprĂŒfend“ – die LĂŒcken zwischen den Zeichen helfen, Fehler zu isolieren –, was es gut fĂŒr Drucker mit niedriger Auflösung oder Ă€ltere industrielle Scanner geeignet macht.

    Code 39 findet man noch in:
    – US-Verteidigungsministerium (LOGMARS-Standard)
    – Gesundheitswesen – internes Tracking
    – Automobilindustrie – Altsysteme

    Das Problem entsteht beim Code 39 Extended. Um ein einziges Kleinbuchstaben-„a“ zu codieren, muss „+A“ gedruckt werden – die Barcode-LĂ€nge verdoppelt sich. Wenn Tracking-IDs Groß-/Kleinbuchstaben mischen, ist Code 39 Extended eine schlechte Wahl.

    Technische Spezifikationen: X-Dimension und Quiet Zones

    Wie gut ein Barcode scannt, hĂ€ngt von der X-Dimension ab – der Breite des schmalsten Balkens. GemĂ€ĂŸ den GS1-Standards 2026 liegt die Mindest-X-Dimension fĂŒr Kassen im Einzelhandel bei 0,264 mm (0,0104 Zoll).

    Beide Formate benötigen außerdem eine Quiet Zone – freie weiße FlĂ€che an beiden Enden des Barcodes, mindestens 10× der Breite des schmalsten Balkens. Ohne sie kann der Scanner nicht erkennen, wo der Barcode beginnt und endet.

    Scanner-KompatibilitÀt

    Scannertyp Funktioniert am besten mit Hinweise
    Laserscanner LĂ€ngere, höhere Barcodes Brauchen einen klaren Laserpfad ĂŒber alle Balken
    FlÀchen-Imager (Standard 2026) Beide Formate, inkl. hochdichtem Code 128 Können beschÀdigte oder geneigte Etiketten lesen
    Smartphone-Kameras Beide Native UnterstĂŒtzung in iOS/Android

    Laut Gitnux 2024 wickelt der Einzelhandel 42 % der weltweiten tĂ€glichen Scans ab – deshalb bewegt sich die Branche in Richtung zuverlĂ€ssigerer FlĂ€chen-Imaging-Standards.

    Fazit

    Code 39 ist fĂŒr einfache, kurze interne Tracking-IDs in Ordnung – besonders in Altsystemen mit Ă€lteren Scannern. Code 128 ist fĂŒr alles andere die klare Wahl: Es ist kleiner, unterstĂŒtzt mehr Zeichen, bietet eine zwingende FehlerprĂŒfung und ist das RĂŒckgrat der modernen Logistik.

    Entscheidungsregel:
    – Daten kĂŒrzer als 10–15 Zeichen, nur Großbuchstaben → Code 39 ist akzeptabel
    – Alles LĂ€ngere oder mit Groß-/Kleinschreibung / Symbolen → Code 128
    – GS1-128-KonformitĂ€t erforderlich → Code 128 (keine Alternative)

    Beim Etiketten-Design sollte der schmalste Balken die GS1-Norm von 0,264 mm erfĂŒllen, um weltweite Lesbarkeit zu garantieren.

    FAQ

    Kann Code 39 Kleinbuchstaben codieren?

    Standard-Code 39 unterstĂŒtzt nur Großbuchstaben, Ziffern und wenige Symbole. FĂŒr Kleinbuchstaben wird Code 39 Extended benötigt, das Zeichenpaare verwendet (z. B. „+A“ fĂŒr „a“). Das vergrĂ¶ĂŸert die physische LĂ€nge des Barcodes erheblich und macht ihn deutlich weniger effizient als Code 128.

    Warum ist Code 128 „dichter“ als Code 39?

    Code 128 verwendet vier Balken-/LĂŒckenbreiten (gegenĂŒber zwei bei Code 39), und sein Code-Set C codiert zwei Ziffern pro Symbol. Dadurch ist Code 128 bei numerischen Daten etwa doppelt so dicht wie Code 39 und spart wertvollen Etikettenplatz.

    Brauche ich eine PrĂŒfziffer fĂŒr Code-39-Barcodes?

    FĂŒr Code 39 ist sie optional, aber in kritischen Umgebungen empfohlen. Code 128 hat eine zwingende Modulo-103-PrĂŒfsumme, die fest in der Spezifikation verankert ist, und ist damit beim Scannen hoher Mengen grundsĂ€tzlich zuverlĂ€ssiger.

    Welcher Barcode-Typ ist besser fĂŒr kleine Objekte mit begrenztem Etikettenplatz?

    Code 128 – seine höhere Dichte erlaubt es, ihn bei gleichem Platzbedarf mit einer grĂ¶ĂŸeren X-Dimension (leichter fĂŒr Scanner zu lesen) zu drucken, wo ein Code-39-Barcode eingeengt und schwer lesbar wĂ€re.

  • ZufĂ€llige Telefonnummern-Generatoren: Testing, SMS-Verifizierung & DevOps-Integration

    ZufÀllige Telefonnummern-Generatoren: Testing, SMS-Verifizierung & DevOps-Integration

    Ein zufĂ€lliger Telefonnummern-Generator erzeugt gĂŒltig aussehende synthetische Nummern fĂŒr Database Seeding und UI-Tests — aber diese Nummern können keine SMS empfangen. FĂŒr eine tatsĂ€chliche Verifizierung (OTP-Codes, Kontoanmeldungen) benötigen Sie echte Non-VoIP-TemporĂ€rnummern, die an zellulare Infrastruktur angebunden sind. Dieser Leitfaden behandelt beide AnwendungsfĂ€lle und erklĂ€rt, warum moderne Plattformen synthetische Nummern blockieren.

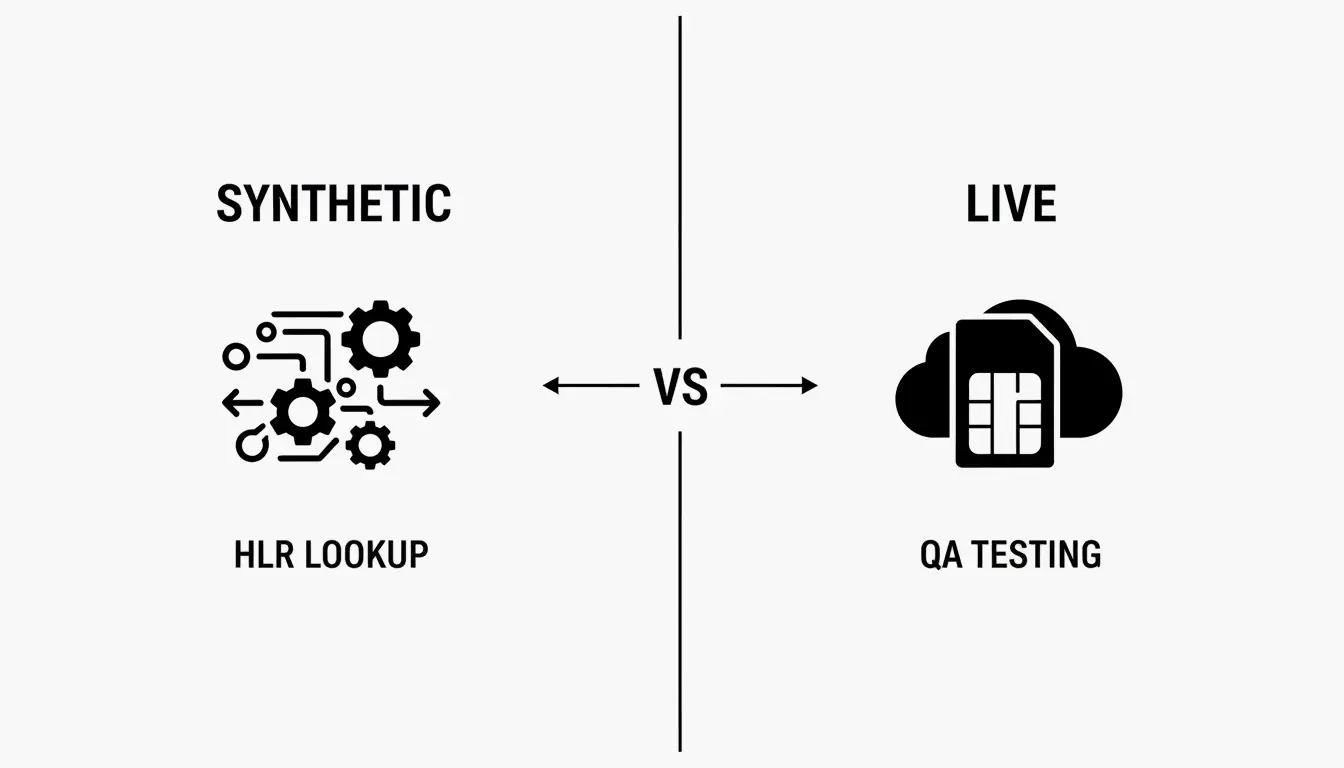
    Synthetische Nummern vs. Live-Nummern: Zwei verschiedene Werkzeuge

    Eigenschaft Synthetisch (generiert) Live (gemietete Non-VoIP)
    Mit Netzwerk verbunden Nein Ja — zellulare Infrastruktur
    Kann SMS/OTP empfangen Nein Ja
    Kosten Kostenlos Kostenpflichtiger Service
    Am besten fĂŒr DB-Seeding, UI-Tests, Stresstests SMS-Verifizierung, Kontoanmeldungen
    FormatkonformitÀt Folgt NANP/E.164-Regeln Echte netzbetreiberzugewiesene Nummer

    Wie Quackr es ausdrĂŒckt: Eine generierte Nummer ist ein „Requisit“; eine Verifizierungsnummer ist „Infrastruktur“.

    Ein einfacher 2-Knoten-Vergleich zwischen synthetischen Daten und Live-Infrastruktur.

    GĂŒltige Testdaten erzeugen: E.164 und CSPRNG

    Der E.164-Standard

    FĂŒr globale KompatibilitĂ€t verwenden Sie immer das E.164-Format: ein +-Zeichen gefolgt von Landesvorwahl, Ortsvorwahl und Teilnehmernummer — ohne Leerzeichen oder Bindestriche.

    Format Beispiel Anwendungsfall
    E.164 +14155550100 Maschinenlesbar, API-/Datenbankstandard
    National (415) 555-0100 Lokale Anzeige in Apps
    International +1 415-555-0100 Menschenlesbar mit Landesvorwahl

    CSPRNG fĂŒr unverfĂ€lschte Testdaten

    Verwenden Sie einen kryptografisch sicheren Pseudozufallszahlengenerator (CSPRNG), um vorhersagbare Muster in TestdatensĂ€tzen zu vermeiden. Tools wie Generate-Random.org nutzen CSPRNG, um sicherzustellen, dass Ziffern nicht verzerrt sind, was automatisierte Tests statistisch gĂŒltig hĂ€lt.

    GadegetKit berichtet, dass ein Fintech-QA-Team die Einrichtungszeit fĂŒr End-to-End-Skripte um 65 % verkĂŒrzen konnte, indem es Massen-SynthetikdatensĂ€tze in Staging-Umgebungen verwendete.

    Code-Beispiele fĂŒr Ihre CI/CD-Pipeline

    Python — NANP-konforme Ortsvorwahlen generieren:

    import secrets
    
    area_code = str(secrets.randbelow(8) + 2)  # 2-9
    exchange = str(secrets.randbelow(800) + 200)  # 200-999
    subscriber = f"{secrets.randbelow(10000):04d}"
    phone = f"+1{area_code}{exchange}{subscriber}"
    

    JavaScript — Browserseitige Generierung mit crypto.getRandomValues():

    const buf = new Uint32Array(1);
    crypto.getRandomValues(buf);
    const areaCode = 200 + (buf[0] % 800);  // 200-999
    

    Reservierte Bereiche fĂŒr sicheres Testen

    In den USA und Kanada ist 555-0100 bis 555-0199 speziell fĂŒr fiktive Verwendung reserviert. Verwenden Sie diese Bereiche immer fĂŒr Dokumentation und Tests, um zu vermeiden, dass versehentlich echte Personen kontaktiert werden.

    Warum Plattformen Verifizierungen blockieren: HLR- und VoIP-Filter

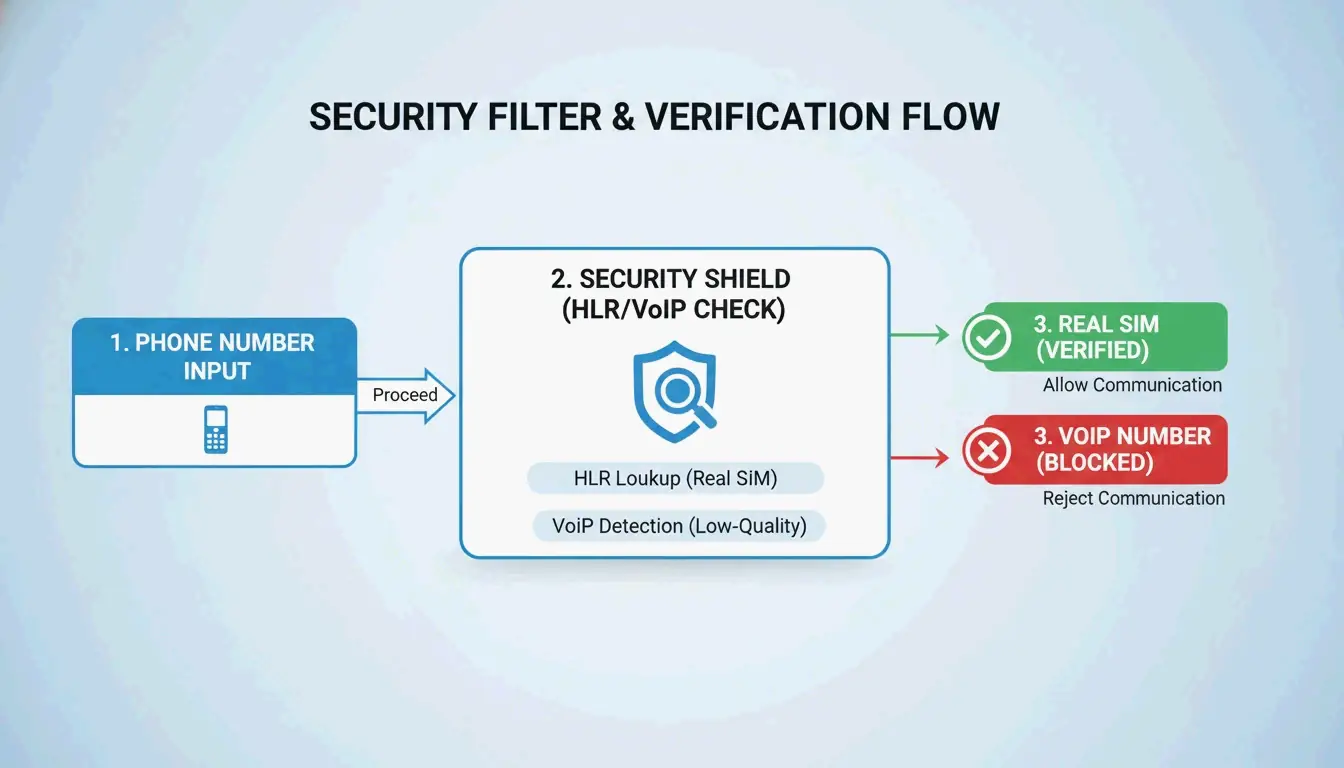
    Wenn Sie schon einmal eine kostenlose virtuelle Nummer fĂŒr WhatsApp oder Instagram ausprobiert haben und die Fehlermeldung „ungĂŒltige Nummer“ erhalten haben, sind Sie auf einen VoIP-Filter gestoßen. Moderne Plattformen unterscheiden zwischen:

    • VoIP-Nummern — ĂŒber das Internet geroutet, leicht in großen Mengen beschaffbar, hĂ€ufig fĂŒr Spam verwendet
    • Non-VoIP-Nummern — an physische SIM-Karten und Mobilfunkmasten gebunden, mit legitimen Netzbetreiber-Signaturen

    Im Jahr 2026 nutzen große Dienste HLR-Abfragen (Home Location Register), um zu prĂŒfen, ob eine Nummer einem echten Teilnehmer zugewiesen ist, bevor eine SMS verschickt wird. Eine Studie aus dem Jahr 2023 des IMDEA Software Institute analysierte 70 Millionen SMS-Nachrichten und fand heraus, dass öffentliche Disposable-Phone-Number-Plattformen (DPN) ein großer Betrugsvektor sind. Infolgedessen verlangen Social-Media- und Banking-Apps heute Non-VoIP-Zellularnummern fĂŒr die Verifizierung.

    Eine 3-stufige VerifizierungsprĂŒfung: Nummerneingabe -> HLR/VoIP-PrĂŒfung -> Zugriff gewĂ€hrt/verweigert.

    Database Seeding im großen Maßstab

    FĂŒr Massendaten generieren Tools wie CodeItBro regionsspezifische Nummern (Ontario +1-416, Kalifornien +1-213) und exportieren diese als CSV oder JSON fĂŒr SQL-/NoSQL-Datenbanken — und simulieren so vielfĂ€ltige Nutzerbasen, ohne echte Daten zu berĂŒhren.

    DevOps-Integration: Automatisierte QA-Workflows

    Der TRNG-Technologiemarkt wÀchst mit 10,98 % CAGR und soll laut GadegetKit bis 2032 9,19 Milliarden Dollar erreichen. Dies spiegelt die Nachfrage nach hoch-entropischen Daten in QA-Umgebungen wider.

    Best Practices fĂŒr 2026

    1. Synthetische Daten klar kennzeichnen in Staging-Umgebungen, damit Produktionssysteme niemals versehentlich generierte Nummern kontaktieren
    2. Massen-JSON-Generierung verwenden (bis zu 1.000 Nummern) fĂŒr automatisierte Regressionstests
    3. FormatkonformitĂ€t validieren — sicherstellen, dass alle generierten Nummern E.164-Regex-PrĂŒfungen bestehen
    4. Test-Pipelines trennen — synthetische Daten fĂŒr interne QA, gemietete Non-VoIP-Nummern fĂŒr Live-Verifizierungstests

    Fazit

    Synthetische Telefonnummern-Generatoren sind unerlĂ€sslich fĂŒr Database Seeding und UI-Tests — verwenden Sie das E.164-Format und CSPRNG fĂŒr gĂŒltige, unverfĂ€lschte Daten. Aber sie können keine SMS empfangen. FĂŒr eine tatsĂ€chliche Verifizierung benötigen Sie Non-VoIP-Zellularnummern, die HLR-PrĂŒfungen bestehen. Der beste Ansatz fĂŒr 2026: Synthetik-Generatoren fĂŒr interne QA-Geschwindigkeit, gemietete Non-VoIP-Nummern fĂŒr Live-Verifizierungstests.

    FAQ

    Kann eine zufÀllig generierte Telefonnummer einen Verifizierungscode empfangen?

    Nein. Synthetische Nummern sind formatierte Ziffernfolgen — sie haben keine SIM-Karte, keine Netzwerkroute und keine Netzbetreiberzuweisung. Um eine SMS oder OTP zu empfangen, benötigen Sie eine aktive Live-TemporĂ€rnummer oder einen Non-VoIP-Service, der aktiv von einem zellularen Netzbetreiber geroutet wird.

    Was ist der Unterschied zwischen E.164-, National- und International-Formaten?

    • E.164: Globaler maschinenlesbarer Standard — +14155550101 (ohne Leerzeichen)
    • National: Lokales Anzeigeformat — (415) 555-0101 in den USA
    • International: Menschenlesbar mit Landesvorwahl — +1 415-555-0101

    Verwenden Sie fĂŒr Datenbanken und APIs immer E.164.

    Warum blockieren Apps wie WhatsApp oder Instagram temporÀre Telefonnummern?

    Diese Plattformen nutzen HLR-Abfragen und DPN-Datenbanken (Disposable Phone Number), um VoIP-Signaturen und massenregistrierte Nummernbereiche zu identifizieren. Im Jahr 2026 priorisieren sie Non-VoIP-Nummern, die an physische zellulare Infrastruktur gebunden sind, um bot-gesteuerten Spam und Betrug zu verhindern.

    Ist es legal, gefĂ€lschte Telefonnummern fĂŒr Online-Anmeldungen zu verwenden?

    Synthetische Nummern sind legal fĂŒr Softwaretests, Design-Mockups und Datenschutz. Es ist jedoch illegal, sie zu verwenden, um die Nutzungsbedingungen einer Plattform zu verletzen, Betrug zu begehen oder andere zu belĂ€stigen. Verwenden Sie fĂŒr Tests und Dokumentation immer reservierte Bereiche (wie 555-01XX), um zu vermeiden, dass echte Personen kontaktiert werden.

  • Bestandsverwaltung fĂŒr KMU: Ein kostengĂŒnstiges Barcode-System fĂŒr Anlagevermögen 2026

    Bestandsverwaltung fĂŒr KMU: Ein kostengĂŒnstiges Barcode-System fĂŒr Anlagevermögen 2026

    Ein kostengĂŒnstiges Barcode-System fĂŒr das Anlagevermögen fĂŒr Ihr KMU im Jahr 2026 bedeutet: Vermögenswerte in einer Cloud-Plattform erfassen, fĂŒr jeden Gegenstand eindeutige QR-Codes erzeugen, strapazierfĂ€hige Etiketten drucken und per Smartphone oder KI-gestĂŒtztem GerĂ€t scannen. Der Ertrag: Die Bestandsgenauigkeit steigt von 63 % auf 99 %, laut Team Unicommerce.

    Hier ist ein praktischer FĂŒnf-Punkte-Plan, um dieses Ziel ohne Enterprise-Budget zu erreichen.

    In 5 Schritten zum kostengĂŒnstigen Barcode-System fĂŒr Anlagevermögen

    Schritt 1: Die SKU-Architektur definieren

    Jedes Anlagegut – ein Laptop, eine Bohrmaschine, ein Firmenfahrzeug – braucht seinen eigenen, eindeutigen Identifikator, damit Sie die vollstĂ€ndige Historie verfolgen können (Kaufdatum, Wartungsprotokoll, Abschreibung). Standardartikel des Lagerbestands hingegen können eine gemeinsame SKU fĂŒr die Sammelverfolgung nutzen.

    Wie QuickBooks erklĂ€rt, ist ein logisches SKU-System (etwa TS-WHITE-S fĂŒr ein kleines weißes T-Shirt) die Grundlage fĂŒr jede Automatisierungsebene, die Sie spĂ€ter hinzufĂŒgen.

    Anlagentyp Kennzeichnungsstrategie Beispiel-SKU
    Anlagevermögen (eindeutig) Ein QR-Code pro Einheit LAPTOP-2026-0042
    Lagerbestand (Sammel) Ein Barcode pro Produktvariante TS-WHITE-S

    Schritt 2: GĂŒnstige Cloud-Software wĂ€hlen

    Sie brauchen kein Enterprise-ERP. Diese Cloud-Plattformen decken die BedĂŒrfnisse von KMU ab:

    Plattform Ideal fĂŒr Gratis-Tarif
    Zoho Inventory Einsteiger, Mehrkanalvertrieb Bis zu 50 Bestellungen/Monat
    inFlow Inventory Individueller Etikettendruck + mobiler Scan EingeschrÀnkter Gratis-Tarif
    Sortly Visuelle Verfolgung mit FotoanhĂ€ngen Kostenlos fĂŒr kleine Teams

    Schritt 3: Interne Barcodes vs. GS1-Barcodes

    FĂŒr die interne Anlagenverfolgung erzeugen Sie Barcodes kostenlos mit Code 128 oder QR-Codes aus Ihrer Software. GS1-registrierte Barcodes (rund 30 $ pro StĂŒck in kleinen Mengen) benötigen Sie nur, wenn Sie ĂŒber große HĂ€ndler wie Amazon oder Walmart verkauben, merkt inFlow Inventory an.

    Empfehlung fĂŒr die meisten KMU: Standard-QR-Codes, die von Ihrer Bestandssoftware erzeugt werden, sind die flexibelste und kostengĂŒnstigste Wahl.

    Schritt 4: Die passende Hardware wÀhlen

    Option Kosten Ideal fĂŒr
    Smartphone + KI-Scan-App 0 $ zusÀtzlich Niedriges bis mittleres Volumen, mobile Teams
    USB-Barcodescanner 50–150 $ Desktop-Kasse oder Warenannahme
    Bluetooth-Wearablescanner 150–300 $ Lagermitarbeiter, die freihĂ€ndiges Arbeiten brauchen

    Schritt 5: Einen Scan-Workflow aufbauen

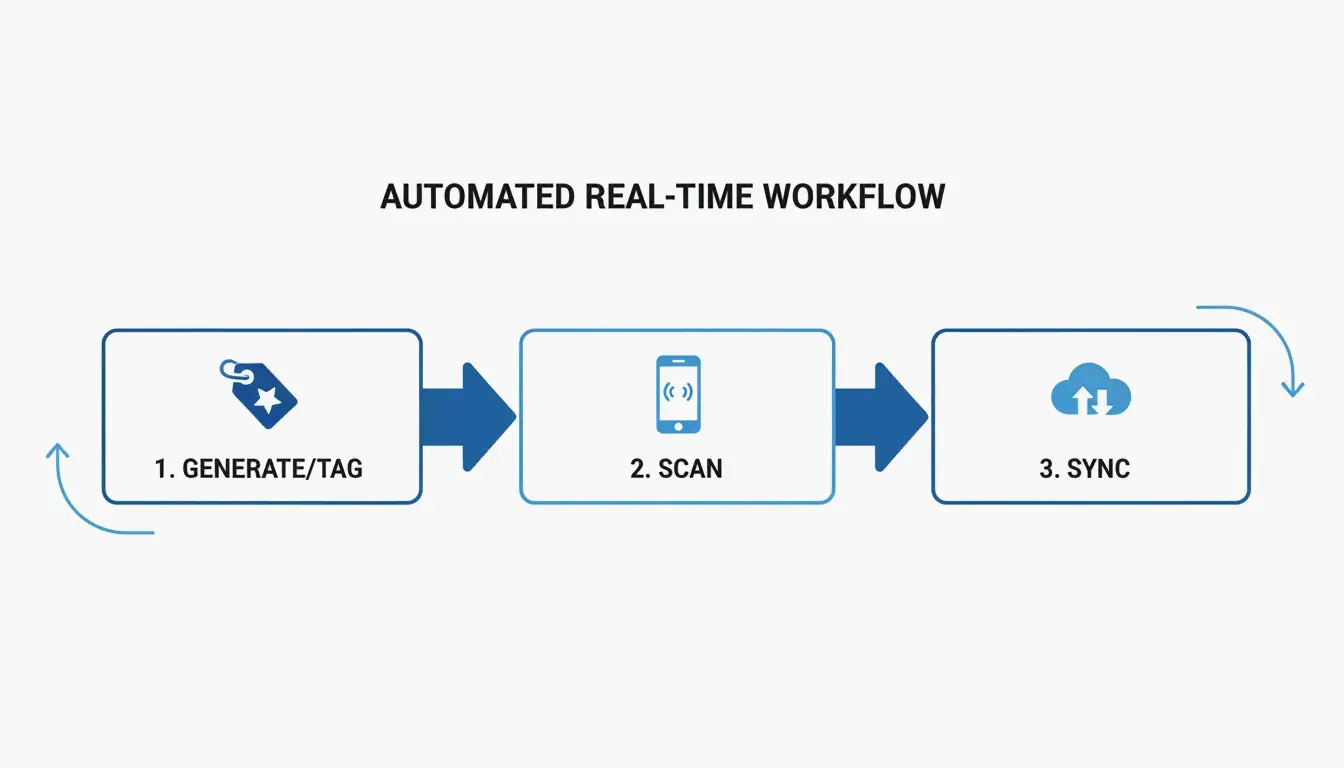
    Machen Sie das Scannen zum Teil des TagesgeschĂ€fts – jeder Eingang, jede Bewegung und jede Aussonderung wird sofort protokolliert. So entsteht Echtzeit-Transparenz ĂŒber alle Standorte. Eine einfache professionelle Ausstattung (Scanner + Etikettendrucker + Software-Abo) kostet typischerweise 200–800 $, laut inFlow Inventory.

    Ein einfacher 3-Schritte-Workflow: Anlage markieren -> Mit dem Smartphone scannen -> Echtzeit-Update.

    1D- vs. 2D-Barcodes: Welcher fĂŒr Anlagevermögen?

    Die Entscheidung hÀngt von der DatenkapazitÀt ab:

    • 1D-Barcodes (klassische schwarze Streifen) funktionieren fĂŒr die einfache SKU-Identifikation – 20–80 Zeichen.
    • 2D-QR-Codes speichern bis zu 4.000 Zeichen und können Wartungslinks, Chargendaten und Seriennummern einbetten.

    QuickBooks empfiehlt 2D-Codes fĂŒr Anlagevermögen, da sie reichhaltigere Daten unterstĂŒtzen, die ĂŒber den gesamten Lebenszyklus des Anlageguts nĂŒtzlich bleiben.

    Anlagevermögen vs. Lagerbestand: Unterschiedliche Kennzeichnungsstrategien

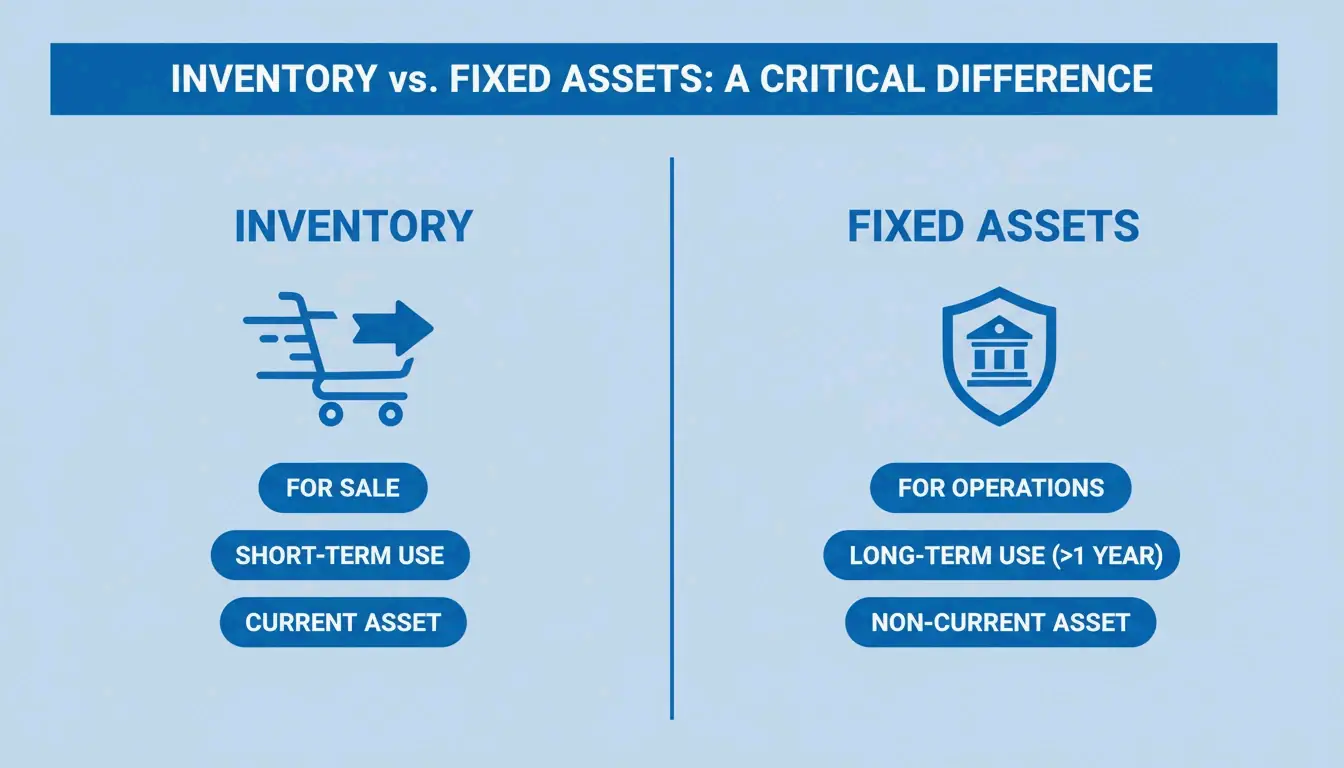
    Ein hÀufiger KMU-Fehler ist, Anlagevermögen und Lagerbestand gleich zu behandeln. Sie sind grundlegend verschieden:

    Eigenschaft Lagerbestand Anlagevermögen
    Lebenszyklus Kurz – Artikel werden verkauft Lang – Artikel bleiben im Unternehmen
    Finanzielle Auswirkung Umsatz Abschreibung ĂŒber die Zeit
    Etikettenhaltbarkeit Standardetiketten IndustriequalitÀt, witterungsbestÀndig

    Ein direkter Vergleich von „Lagerbestand" (Schnell/Verkauft) mit „Anlagevermögen" (Bleibt/Abschreibung).

    GSM Barcoding betont, dass hochwertige Etiketten Barcodes ĂŒber Jahre lesbar halten, selbst in rauen Umgebungen. Eine ordnungsgemĂ€ĂŸe Anlagenverfolgung kann die Betriebskosten um 20 % senken, indem Verluste vermieden und die Auslastung verbessert werden, so TAG Samurai.

    Automatische Abschreibungs-Updates

    Moderne Systeme verknĂŒpfen physische Scans ĂŒber ERP/POS-Integration mit Ihrer Finanzsoftware. Ein einziger Scan aktualisiert Buchhaltungsplattformen wie QuickBooks oder Xero und gibt Finance-Teams Echtzeit-Anlagenwerte und automatisierte AbschreibungsplĂ€ne – ohne manuelle Dateneingabe.

    Hardware 2026: Intelligente Scanner und Wearables

    Die Hardware ist weit ĂŒber Kabel-Scanner hinausgegangen:

    • KI-gestĂŒtzte Smartphones: Mobile Apps von 2026 nutzen Computer Vision, um mehrere Codes gleichzeitig zu scannen, selbst in dunklen Lagern.
    • Wearablescanner: Ring- oder handschuhmontierte GerĂ€te ermöglichen es Mitarbeitern, Artikel zu bewegen und gleichzeitig Daten zu erfassen – freihĂ€ndig.
    • RFID: Teurer als Barcodes, gewinnt aber bei hochwertigen AnlagegĂŒtern an Bedeutung. Keine Sichtlinie nötig – einen ganzen Raum in Sekunden inventarisieren.

    Kosten-Nutzen: GĂŒnstige Software vs. Enterprise-ERP

    FĂŒr die meisten KMU schlĂ€gt eine dedizierte Bestands-App (20–50 $/Monat) ein komplexes Enterprise-ERP. Zwar gibt es kostenlose Open-Source-Optionen wie myWMS oder Openboxes, diese erfordern jedoch erhebliches technisches Know-how zur Wartung.

    The Retail Exec warnt, dass die „versteckten Kosten“ kostenloser Software hĂ€ufig als SicherheitslĂŒcken oder fehlender Support bei kritischen Audits auftauchen.

    Achten Sie auf diese unverzichtbaren Funktionen:
    – Warnungen bei niedrigem Bestand
    – Cloud-Synchronisation ĂŒber alle GerĂ€te
    – Mehrbenutzer-Berechtigungen
    – Massenimport aus Tabellen

    Fazit

    Ein barcodebasiertes Anlagensystem ist fĂŒr KMU, die Genauigkeit und Effizienz anstreben, nicht lĂ€nger optional. Der FĂŒnf-Schritte-Ansatz – SKUs definieren, Cloud-Software wĂ€hlen, interne QR-Codes nutzen, erschwingliche Hardware auswĂ€hlen und einen tĂ€glichen Scan-Workflow aufbauen – kann die Genauigkeit fĂŒr unter 800 $ von 63 % auf 99 % heben.

    NĂ€chster Schritt: Inventarisieren Sie Ihre aktuellen AnlagegĂŒter, wĂ€hlen Sie eine skalierbare Plattform (Zoho, inFlow oder Sortly) und starten Sie einen kleinen QR-Code-Piloten mit einer Anlagenkategorie. Skalieren Sie von dort aus.

    FAQ

    Was kostet der Unterschied zwischen internen Barcodes und GS1-registrierten Barcodes im Jahr 2026?

    Interne Barcodes (Code 128 oder QR-Codes) lassen sich mit Ihrer Bestandssoftware kostenlos erzeugen. GS1-Barcodes erfordern eine jĂ€hrliche Mitgliedschaft plus etwa 30 $ pro Barcode in kleinen Mengen. GS1-Codes benötigen Sie nur, wenn Sie ĂŒber große globale HĂ€ndler wie Walmart oder Amazon verkaufen.

    Kann ich ein Smartphone als professionellen Barcodescanner fĂŒr die Inventur des Anlagevermögens nutzen?

    Ja. Smartphone-Kameras des Jahrgangs 2026 in Kombination mit KI-Scan-Apps bewĂ€ltigen Inventuren mit niedrigem bis mittlerem Volumen effizient und ohne zusĂ€tzliche Hardwarekosten. FĂŒr Hochvolumen-Scans oder raue Umgebungen (Baustellen, Lager) wird ein dedizierter Hand- oder Wearablescanner empfohlen – wegen Haltbarkeit, Geschwindigkeit und Akkulaufzeit.

    Wie wechsle ich von Tabellenkalkulation zu einem automatisierten Barcode-System ohne Ausfallzeit?

    Starten Sie mit einem Pilotprojekt fĂŒr eine Anlagenkategorie. Nutzen Sie die Massen-Upload-Funktion Ihrer neuen Software, um die vorhandenen Tabellendaten zu importieren, bevor Sie Etiketten drucken. FĂŒhren Sie die physische Kennzeichnung in Nebenzeiten durch, um den Tagesbetrieb nicht zu stören. Sobald der Pilot reibungslos lĂ€uft, erweitern Sie Kategorie fĂŒr Kategorie.

  • ISBN-10 vs. ISBN-13: Die wichtigsten Unterschiede, der Umrechnungsleitfaden und das 979-PrĂ€fix erklĂ€rt

    ISBN-10 vs. ISBN-13: Die wichtigsten Unterschiede, der Umrechnungsleitfaden und das 979-PrÀfix erklÀrt

    Jedes heute veröffentlichte Buch trĂ€gt eine 13-stellige ISBN – die universelle Kennung, die es an jedem Kassensystem weltweit scanbar macht. Wer sich lĂ€nger mit BĂŒchern beschĂ€ftigt hat, ist aber sicher auch schon ĂŒber das Ă€ltere 10-stellige Format gestolpert. Die Unterschiede zwischen beiden zu verstehen, zwischen ihnen umzurechnen und zu wissen, warum das neuere „979″-PrĂ€fix alles verĂ€ndert, ist 2026 unverzichtbares Wissen fĂŒr Verlage, Bibliothekare und alle, die mit Buch-Metadaten arbeiten.

    Dieser Leitfaden behandelt die strukturellen Unterschiede, fĂŒhrt Schritt fĂŒr Schritt durch die Umrechnungsmathematik, erklĂ€rt, warum sich ISBNs mit 979-PrĂ€fix nicht zurĂŒck in 10 Stellen wandeln lassen, und zeigt, was ISBNs heute kosten.

    ISBN-10 vs. ISBN-13: Die zentralen Unterschiede

    Der grĂ¶ĂŸte Umbruch im ISBN-System fand am 1. Januar 2007 statt, als die Branche von 10 auf 13 Stellen wechselte. Wie Wikipedia dokumentiert, verfolgte dieser Wechsel zwei Ziele: den weltweit verfĂŒgbaren Nummernpool zu erweitern und BĂŒcher an das EAN-13-Barcodesystem anzupassen, das nahezu jeder EinzelhĂ€ndler verwendet.

    Strukturelle AufschlĂŒsselung

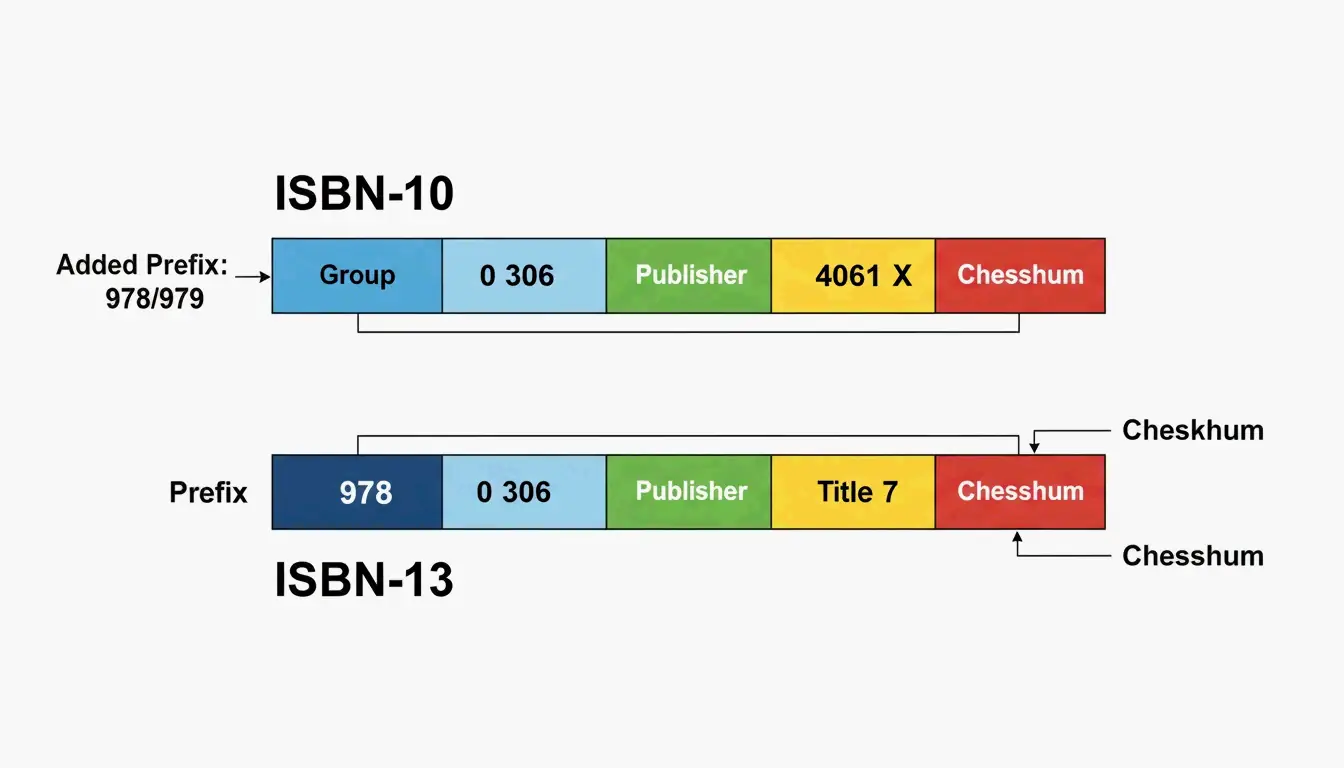
    Bestandteil ISBN-10 ISBN-13
    Stellen gesamt 10 13
    GS1-PrÀfix keines 978 oder 979
    Registrierungsgruppe Sprache/Land Sprache/Land
    Registrierter Verlag Verlag
    Publikation Spezifischer Titel/Edition Spezifischer Titel/Edition
    PrĂŒfziffer Modulo 11 (0–9 oder X) Modulo 10 (nur 0–9)

    LiteDevTools weist darauf hin, dass ISBN-13 heute fĂŒr moderne Bestandssysteme erforderlich ist – sie ermöglicht es, ein Buch an der Kasse ĂŒber dieselben GTIN-13-Datenfelder zu scannen wie jedes andere Konsumprodukt.

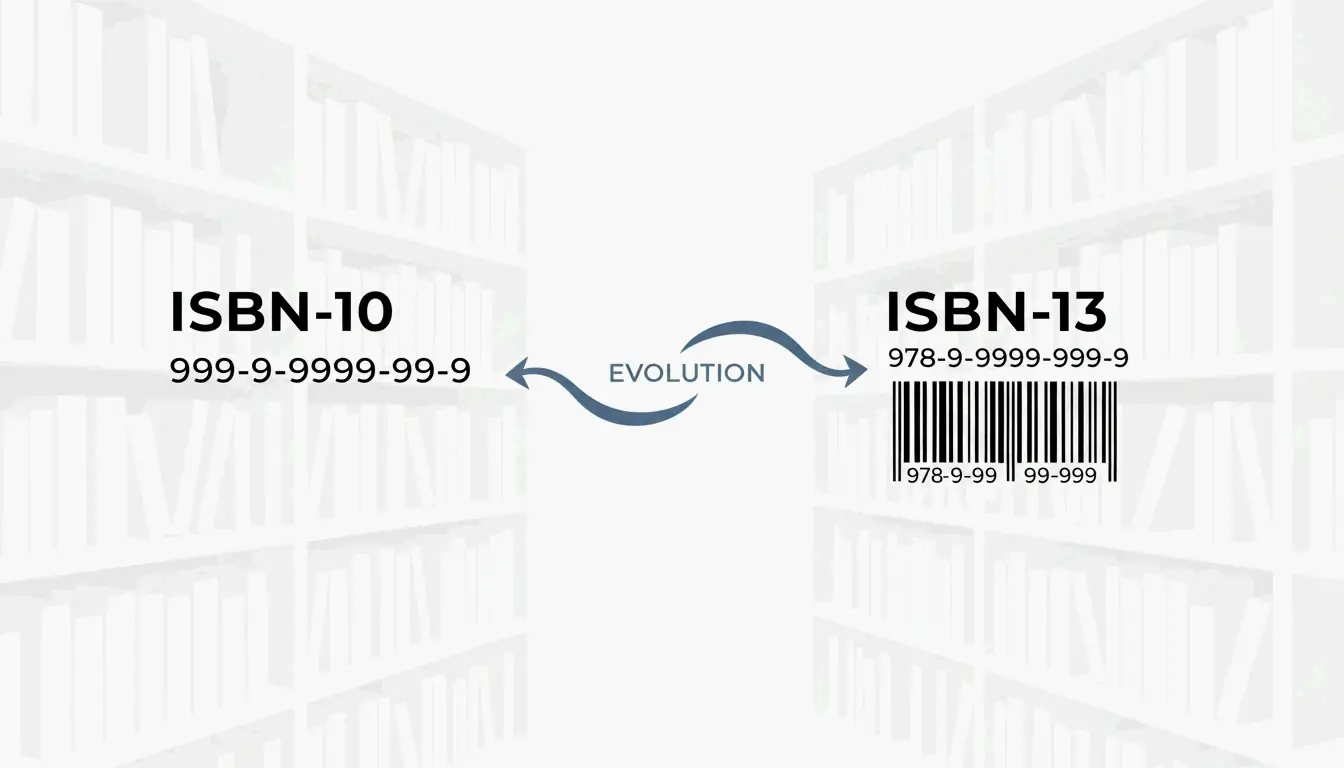
    Direkter Vergleich der Struktur von ISBN-10 und ISBN-13

    Wann welches Format zum Einsatz kommt

    • Moderne Publikationen – Jedes nach 2007 veröffentlichte Buch muss eine ISBN-13 haben.
    • Alte Datenbanken – ISBN-10 ist weiterhin nĂŒtzlich, um alten Lagerbestand zu verfolgen oder Bibliothekskataloge zu pflegen.
    • Barcodes – Der scannbare EAN-13-Barcode auf der BuchrĂŒckseite benötigt die 13-stellige Version.

    Das 979-PrĂ€fix: Warum es nicht zurĂŒckkonvertiert werden kann

    Das „979″-PrĂ€fix war ein Wendepunkt fĂŒr das ISBN-System. UrsprĂŒnglich begannen alle 13-stelligen ISBNs mit „978″ – quasi eine BrĂŒcke, die die 10-stellige Welt mit der 13-stelligen verband. Als das Angebot an 978-Nummern in bestimmten Regionen knapp wurde, fĂŒhrte GS1 das 979-PrĂ€fix als neuen Namensraum ein.

    Regionale 979-Zuweisungen (2026)

    Laut EAN Check sind bestimmte 979-PrĂ€fixe inzwischen fest an Regionen mit hohem Ausstoß vergeben:

    PrÀfix Region / Verwendung
    979-8 Vereinigte Staaten
    979-10 Frankreich
    979-11 Republik Korea
    979-12 Italien
    979-0 International Standard Music Numbers (ISMN)

    Warum 979 keine ISBN-10-Entsprechung hat

    Hier liegt hĂ€ufig ein MissverstĂ€ndnis. WĂ€hrend ISBNs mit 978-PrĂ€fix eine direkte mathematische VerknĂŒpfung zu einem 10-stelligen Äquivalent haben, besitzen 979-ISBNs keine ISBN-10-Entsprechung. Wie Wikipedia erklĂ€rt, existierten diese Registrierungsgruppen im alten 10-stelligen System nie. Wird Ihrem Buch in den USA ein 979-8-PrĂ€fix zugewiesen, existiert es nur als 13-stellige Kennung – es gibt keine Möglichkeit, es „herunterzustufen“.

    Schritt-fĂŒr-Schritt ISBN-Umrechnungsleitfaden

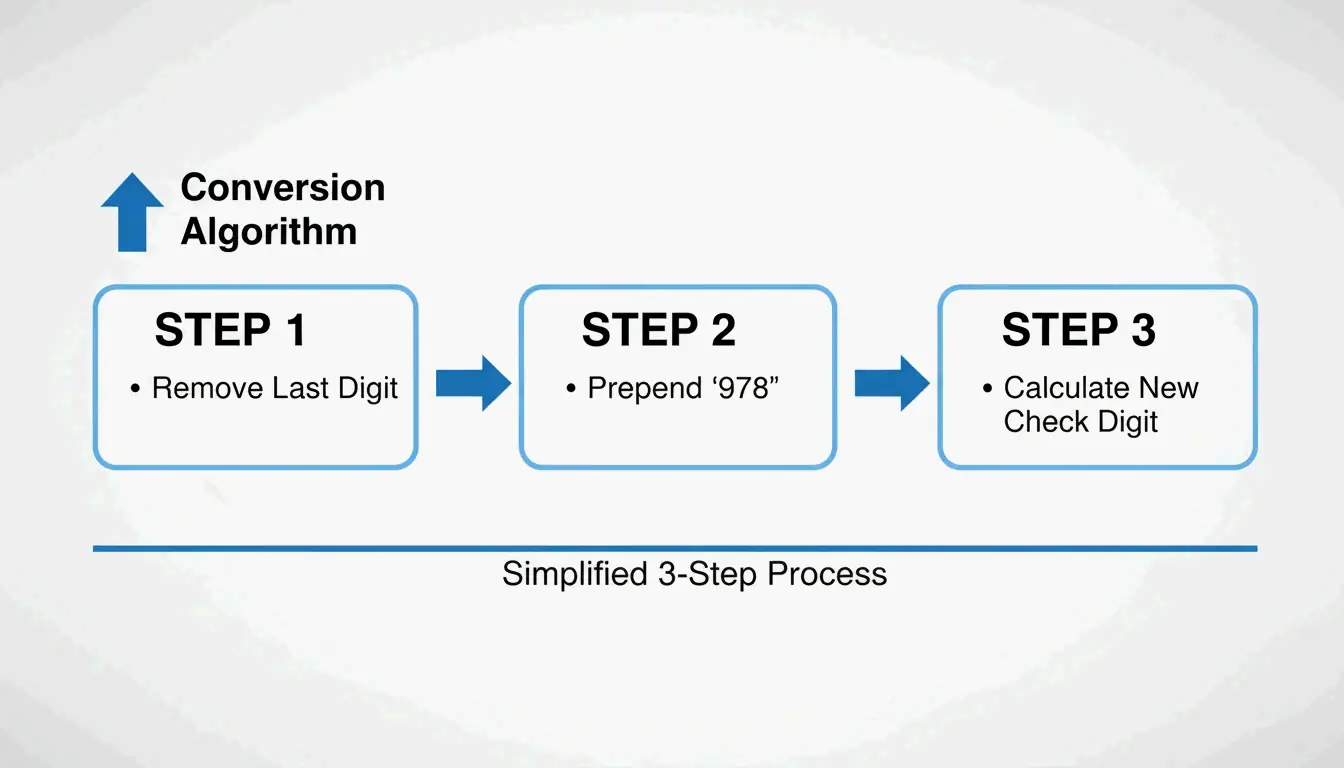
    Die Umwandlung einer ISBN-10 in eine ISBN-13 besteht nicht nur darin, „978″ vorne anzuhĂ€ngen – die finale PrĂŒfziffer muss komplett neu berechnet werden.

    So wandeln Sie ISBN-10 in ISBN-13 um

    1. PrĂŒfziffer streichen – Entfernen Sie das letzte Zeichen (die 10. Ziffer) aus Ihrer ISBN-10.
    2. „978″ voranstellen – FĂŒgen Sie es vor die verbleibenden 9 Ziffern.
    3. Neue PrĂŒfziffer berechnen mit dem GS1-Modulo-10-Algorithmus:
    4. Jede der 12 Ziffern mit abwechselnden Gewichtungen von 1 und 3 multiplizieren (beginnend mit 1).
    5. Alle Produkte addieren.
    6. Den Rest bei Division durch 10 ermitteln.
    7. Den Rest von 10 abziehen. (Ist das Ergebnis 10, lautet die PrĂŒfziffer 0.)

    Drei-Schritt-Methode zur Umrechnung von ISBN-10 nach 13

    Durchgerechnetes Beispiel

    EAN Check zeigt, dass ISBN-10 0-306-40615-2 in ISBN-13 978-0-306-40615-7 umgewandelt wird. Beachten Sie, dass sich die PrĂŒfziffer von 2 auf 7 geĂ€ndert hat – das passiert, weil Gewichtungen und Modulus zwischen den beiden Systemen unterschiedlich sind.

    Warum sich die PrĂŒfziffer Ă€ndert

    ISBN-10 verwendet Modulo 11 (das den Buchstaben „X“ fĂŒr den Wert 10 erlaubt), wĂ€hrend ISBN-13 Modulo 10 verwendet (nur Ziffern 0–9). Da Mathematik und Gewichtungen abweichen, Ă€ndert sich die PrĂŒfziffer bei der Umrechnung fast immer.

    Publishing-Standards 2026: Kosten und Anforderungen

    In den USA ist Bowker die allein autorisierte ISBN-Agentur. FĂŒr Self-Publisher ist die Kostenstruktur entscheidend.

    Bowker-Preise (2026)

    Laut Books.by:

    Menge Preis Pro ISBN
    1 ISBN 125 $ 125,00 $
    10 ISBNs 295 $ 29,50 $
    100 ISBNs 575 $ 5,75 $

    Books.by weist darauf hin, dass der Preis von 125 $ fĂŒr eine einzelne ISBN eine kleine Falle ist – da jedes Format Ihres Buches (Taschenbuch, Hardcover, E-Book, Hörbuch) eine eigene ISBN benötigt, ist ein 10er-Pack fĂŒr Indie-Verlage fast immer die klĂŒgere Wahl.

    Jedes Format benötigt eine separate ISBN

    Format ISBN erforderlich? Hinweise
    Print (Taschenbuch/Hardcover) Ja Erforderlich fĂŒr Buchhandlungen und Bibliotheken
    E-Book (Amazon KDP) Optional Amazon vergibt eigene ASIN
    E-Book (andere Plattformen) Ja OverDrive und Bibliotheksplattformen verlangen sie
    Hörbuch Ja Von ACX, Findaway Voices gefordert

    Internationaler Vergleich

    Die USA sind ungewöhnlich, da sie fĂŒr ISBNs Geld verlangen. Wikipedia und Books.by berichten, dass ISBNs in Kanada, Indien und Neuseeland kostenlos sind, wo die Regierung das System direkt verwaltet.

    Fazit

    Der Wechsel von ISBN-10 zu ISBN-13 ist kein bloßes technisches Detail – er ist die Voraussetzung, um Ihr Buch in die moderne Lieferkette zu bringen. ISBN-10 bleibt als historisches Werkzeug fĂŒr Altdatenbanken nĂŒtzlich, doch das 13-stellige Format ist die globale Sprache des Buchmarkts 2026. Das Aufkommen des 979-PrĂ€fixes in den USA und Europa unterstreicht dies: Das alte 10-stellige System hat seine Grenzen erreicht.

    FĂŒr die meisten Verlage lautet die praktische Erkenntnis: ISBN-13-Codes in grĂ¶ĂŸeren Mengen (10er- oder 100er-Packs) kaufen, um jedes Format abzudecken, Validierungstools nutzen, um die Metadaten sauber zu halten, und nicht versuchen, Nummern mit 979-PrĂ€fix in 10 Stellen zurĂŒckzuwandeln – das geht nicht.

    FAQ

    Warum wurde die ISBN 2007 von 10 auf 13 Stellen geÀndert?

    Um einem Mangel an verfĂŒgbaren Nummern angesichts wachsender globaler Buchproduktion vorzubeugen und das ISBN-System an den GS1-EAN-13-Barcode-Standard anzugleichen, den EinzelhĂ€ndler weltweit verwenden. So können BĂŒcher mit derselben AusrĂŒstung gescannt werden wie jedes andere Konsumprodukt.

    Kann jede ISBN-13 in eine ISBN-10 umgewandelt werden?

    Nein. Nur ISBN-13-Nummern, die mit „978″ beginnen, lassen sich in 10 Stellen zurĂŒckverwandeln. Nummern, die mit „979″ beginnen, gehören zu einem neueren Namensraum, der nie Teil des 10-stelligen Systems war – sie haben kein ISBN-10-Äquivalent.

    Was bedeutet das „X“ in einigen ISBN-10-Nummern?

    Das „X“ steht als PrĂŒfziffer fĂŒr den Wert 10. Da ISBN-10 fĂŒr die Fehlererkennung Modulo 11 verwendet, gibt es 11 mögliche Reste (0–10). Um die ISBN bei genau 10 Zeichen zu halten, wurde die römische Ziffer „X“ fĂŒr einen Rest von 10 ĂŒbernommen.

    Brauche ich fĂŒr mein E-Book und mein Taschenbuch unterschiedliche ISBNs?

    Ja. Jedes eigenstĂ€ndige Format und jede Edition – Taschenbuch, Hardcover, E-Book und Hörbuch – benötigt eine eigene, einzigartige ISBN. So können EinzelhĂ€ndler und Bibliotheken jedes Produkt separat erfassen, selbst wenn der Textinhalt identisch ist.

    Wo sollte die ISBN auf einem physischen Buch platziert werden?

    Laut dem ISBN-Benutzerhandbuch muss die Nummer auf der Impressumseite (RĂŒckseite der Titelseite) und im unteren Bereich der Außenseite des hinteren Einbands erscheinen. Bei PrintbĂŒchern wird die ISBN typischerweise in einen EAN-13-Barcode fĂŒr den Einzelhandel-Scan integriert.

  • Wie echte Zufallszahlen entstehen: TRNG, PRNG und CSPRNG erklĂ€rt

    Wie echte Zufallszahlen entstehen: TRNG, PRNG und CSPRNG erklÀrt

    Die echte Zufallszahlengenerierung funktioniert, indem physikalische Entropie geerntet wird – thermisches Rauschen, atmosphĂ€rische Störungen, quantenmechanischer Zerfall – und diese chaotischen analogen Signale in digitale Bits umgewandelt werden. Im Gegensatz zu algorithmenbasierten Generatoren messen hardwaregestĂŒtzte Systeme nicht-deterministische Umgebungsvariablen, um Sequenzen zu erzeugen, die mathematisch unvorhersehbar und frei von Mustern sind.

    Hier erfahren Sie, wie die Technologie funktioniert, wo sie versagt und wie Sie den richtigen Ansatz fĂŒr Ihren Anwendungsfall wĂ€hlen.

    Wie ein TRNG funktioniert: Vom physikalischen Chaos zu digitalen Bits

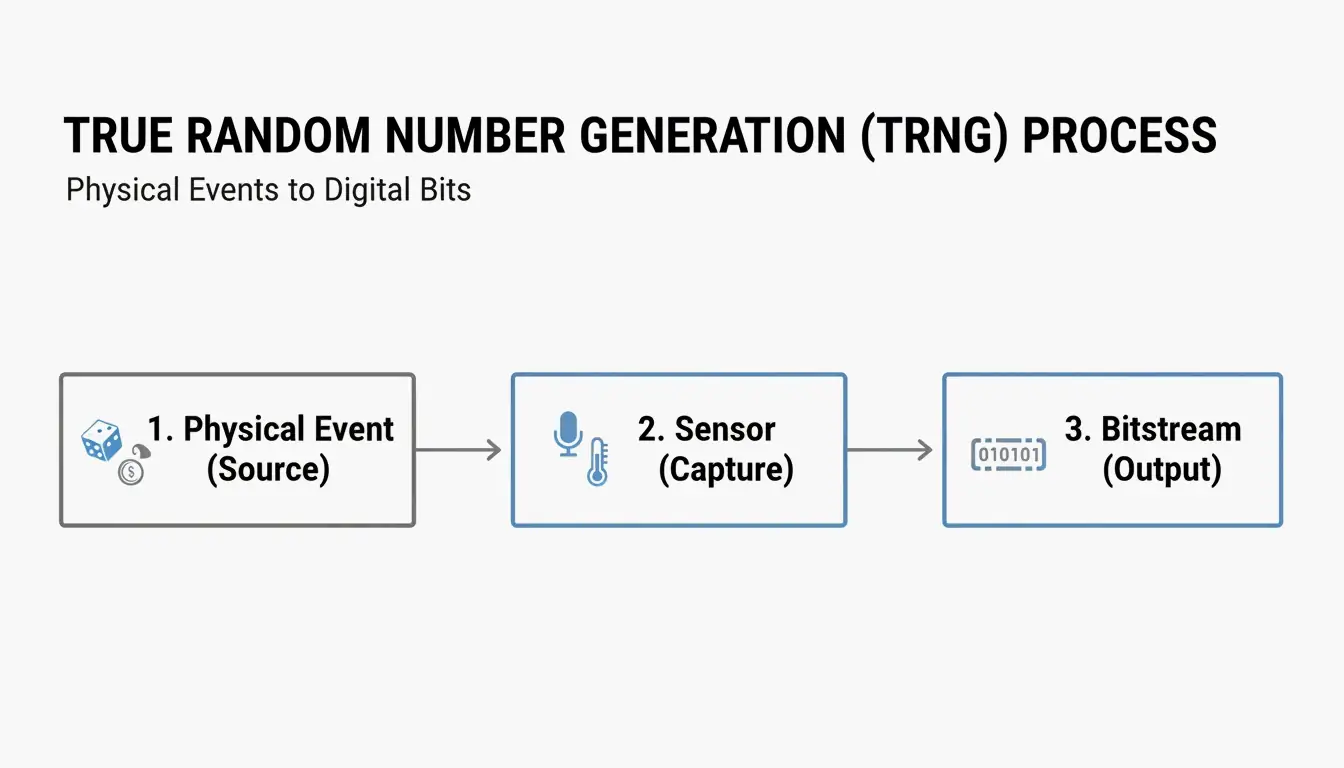
    Ein True Random Number Generator (TRNG) – auch Hardware Random Number Generator (HRNG) genannt – folgt keiner Formel. Er verbindet die unvorhersehbare physische Welt mit der strengen Logik digitaler Systeme, indem er eine externe Entropiequelle erfasst und deren analoges Signal in einen binĂ€ren Datenstrom umwandelt.

    Wie John von Neumann bereits 1951 warnte: „Wer arithmetische Methoden zur Erzeugung von Zufallsziffern in Betracht zieht, befindet sich natĂŒrlich im Zustand der SĂŒnde.“

    Drei gÀngige Entropiequellen

    Quelle Was sie misst GerÀtebeispiel
    Thermisches Rauschen Spannungsschwankungen durch Elektronenbewegung in Schaltkreisen Smartphone Secure Enclaves (Apple A-Serie, Google Tensor)
    AtmosphÀrisches Rauschen Funkstörungen durch Naturereignisse wie Blitze Dedizierte RNG-Server
    QuantenphÀnomene Radioaktiver Zerfall, Vakuumfluktuationen ANU Quantum RNG, Unternehmensserver

    Eine einfache 3-stufige Pipeline: Physikalische Quelle -> Sensor/Digitalisierer -> BinÀre Ausgabe.

    Die Pipeline ist simpel: Physikalische Quelle → Sensor/Digitalisierer → BinĂ€re Ausgabe. Roh-Entropie geht auf der einen Seite hinein; saubere Zufallsbits kommen auf der anderen heraus.

    TRNG vs. PRNG: Die deterministische Trennlinie

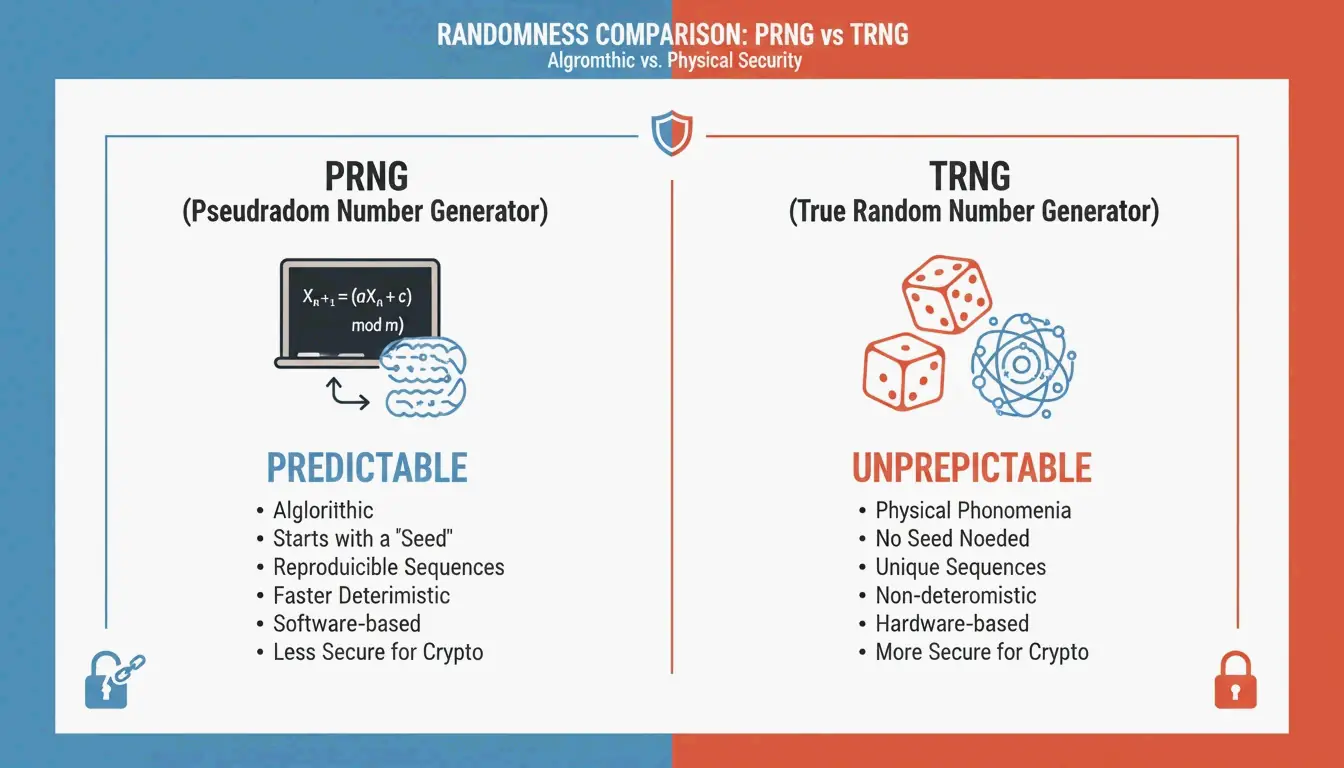
    Die zentrale Trennung bei der Zufallszahlengenerierung verlÀuft zwischen physikalischer Entropie und algorithmischer Logik.

    Eigenschaft TRNG (Hardware) PRNG (Algorithmisch) CSPRNG (Hybrid)
    Quelle Physische Entropie Mathematische Formel Hardware-Seed + Algorithmus
    Vorhersehbar? Nein Ja – wenn der Seed bekannt ist Äußerst schwierig
    Geschwindigkeit Langsamer (blockierend) Sehr schnell Schnell
    Reproduzierbar? Nein Ja (gleicher Seed = gleiche Ausgabe) Nein
    Anwendungsfall VerschlĂŒsselungsschlĂŒssel, Sicherheitstokens Simulationen, Spiele Produktionssicherheitssysteme

    Wenn PRNGs versagen: Der Hot Lotto Betrug

    Ein PRNG verwendet einen Seed-Wert als Startpunkt fĂŒr eine mathematische Formel. Die Ausgabe wirkt zufĂ€llig, ist aber vollstĂ€ndig deterministisch. Werden Seed und Formel bekannt, lĂ€sst sich jede Zahl vorhersagen.

    Das ist keine Theorie. Beim Hot Lotto Betrugsskandal installierte ein Insider Schadsoftware, die den PRNG wĂ€hrend der Wartung zwang, einen vorhersehbaren Seed zu verwenden – und manipulierte so einen Jackpot von 16,5 Mio. Dollar.

    Ein sauberer Vergleich zwischen PRNG \(deterministisch/schnell\) und TRNG \(nicht-deterministisch/sicher\).

    Wann PRNGs die richtige Wahl sind

    PRNGs sind tatsĂ€chlich besser fĂŒr Aufgaben, bei denen Geschwindigkeit und Reproduzierbarkeit zĂ€hlen. In Monte-Carlo-Simulationen mĂŒssen Wissenschaftler dieselbe Sequenz wiederholt ausfĂŒhren, um Ergebnisse zu verifizieren. Da derselbe Seed wiederverwendet werden kann, bleibt die Simulation konsistent – etwas, das ein blockierender TRNG nicht leisten kann.

    Die hybride Lösung: CSPRNG

    Die meisten modernen Systeme verwenden einen Cryptographically Secure Pseudorandom Number Generator (CSPRNG) – einen Hybrid, der eine kleine Menge echter Hardware-Entropie zieht, um einen schnellen Algorithmus zu seeden. Das liefert die Unvorhersehbarkeit eines TRNG mit der Geschwindigkeit eines PRNG.

    Der Industriestandard ist NIST SP 800-90A, der definiert, wie diese Generatoren fĂŒr staatliche und industrielle Nutzung gebaut werden mĂŒssen.

    Entwickler-Leitfaden: Welche Bibliothek verwenden?

    Sprache Unsicher (PRNG) Sicher (CSPRNG)
    Python random (Mersenne-Twister) secrets (liest aus /dev/urandom)
    JavaScript Math.random() crypto.getRandomValues()
    Go math/rand crypto/rand
    Java java.util.Random java.security.SecureRandom

    Die Regel: Verwenden Sie secrets / crypto / SecureRandom fĂŒr alles Sicherheitsrelevante. Nutzen Sie random / Math.random() nur fĂŒr Spiele und Simulationen.

    TRNGs in Consumer-Hardware 2026

    Bis 2026 ist Hardware-Entropie von Unternehmensservern in alltĂ€gliche GerĂ€te gewandert. Moderne Smartphone-Chips enthalten dedizierte TRNGs in ihren Secure Enclaves und ernten thermisches Rauschen direkt vom Prozessor, um VerschlĂŒsselungs-SchlĂŒssel fĂŒr FaceID, digitale Wallets und sichere Nachrichten zu erzeugen.

    FĂŒr die Unternehmenssicherheit ist die Grenze des Machbaren die Quantum Random Number Generation. Systeme wie jene an der Australian National University erzeugen Zahlen aus Quantenvakuum-Fluktuationen – eine ZufĂ€lligkeit, die selbst zukĂŒnftige Quantencomputer wahrscheinlich nicht knacken können.

    Whitening: Vom Roh-Rauschen zu sauberen Daten

    Rohe Entropie ist selten gleichverteilt. Ein thermischer Sensor könnte aufgrund einer Temperaturdrift minimal mehr 1en als 0en erzeugen. Um diesen Bias zu korrigieren, durchlĂ€uft das Daten das sogenannte Whitening – typischerweise eine XOR-Operation oder einen kryptografischen Hash – um Muster zu glĂ€tten und eine gleichmĂ€ĂŸige Verteilung sicherzustellen.

    Dieser Nachverarbeitungsschritt wird durch NIST SP 800-90B fĂŒr jede Entropiequelle vorausgesetzt, die in einem zertifizierten System verwendet wird.

    Eine kurze Geschichte der Chaos-Ernte

    • 1927: L.H.C. Tippett veröffentlichte eine Tabelle mit 41.600 Ziffern, die manuell aus VolkszĂ€hlungsunterlagen erstellt wurden.
    • 1955: Die RAND Corporation veröffentlichte A Million Random Digits mithilfe einer elektronischen Impulsmaschine.
    • 2013: Der Dual_EC_DRBG-Skandal deckte auf, dass die NSA eine HintertĂŒr in einen NIST-zertifizierten Generator eingebaut hatte, mit der sie SSL-Verbindungen knacken konnten. Dieser Vorfall trieb die Branche hin zur Entropie-Mischung aus mehreren Quellen – kein Single Point of Failure mehr.

    Fazit

    Echte Zufallszahlen sind das Fundament digitalen Vertrauens. Sie erfordern physische Hardware, um vorhersagbaren Code mit chaotischer RealitĂ€t zu verbinden. Ob thermisches Rauschen im Smartphone oder Quantenfluktuationen im Serverraum – der Wechsel von PseudozufĂ€lligkeit zu hardwareverifizierter Entropie ist fĂŒr die Sicherheit 2026 unerlĂ€sslich.

    FĂŒr Entwickler: Verwenden Sie secrets (Python) oder crypto.getRandomValues() (JavaScript), niemals random oder Math.random() fĂŒr Sicherheit. FĂŒr Organisationen: Hardware-TRNGs sind nicht lĂ€nger optional – sie sind eine Grundvoraussetzung fĂŒr VerschlĂŒsselung.

    FAQ

    Ist die interne Uhr meines Computers eine Quelle echter ZufÀlligkeit?

    Nein. Die Uhr ist vorhersagbar und wird oft gerade deshalb als PRNG-Seed verwendet, weil sie sich Ă€ndert. Kennt ein Angreifer jedoch ungefĂ€hr den Zeitpunkt der Generierung, kann er die Möglichkeiten eingrenzen. Echte ZufĂ€lligkeit erfordert das Zeitmessen nicht-deterministischer Ereignisse – Tastatureingabe-Intervalle, thermisches Rauschen – gefolgt von statistischem Whitening.

    Kann ein Mensch eine wirklich zufÀllige Sequenz erzeugen?

    Menschen sind schlecht in ZufĂ€lligkeit. Wir vermeiden HĂ€ufungen (wie „1, 1, 1″), obwohl sie in Zufallsmengen natĂŒrlich vorkommen, und wechseln zu hĂ€ufig zwischen Optionen. Statistische Tests erkennen diese Muster leicht – deshalb ist menschliche Eingabe zum Seeden akzeptabel, fĂŒr sicherheitskritische Aufgaben aber unzureichend.

    Welche statistischen Tests verifizieren echte ZufÀlligkeit?

    Die NIST Statistical Test Suite (STS) ist der Goldstandard. Weitere Frameworks sind die Dieharder-Tests und der AIS 31-Standard. Diese Tests suchen nach sich wiederholenden Mustern, langen Folgen identischer Bits und anderen Anomalien, die auf Bias oder Vorhersehbarkeit hindeuten.

  • QR-Code-Generator: Erstellen Sie benutzerdefinierte scannbare Links in Minuten (2026)

    QR-Code-Generator: Erstellen Sie benutzerdefinierte scannbare Links in Minuten (2026)

    Der schnellste Weg, benutzerdefinierte scannbare Links in Minuten zu erstellen, ist ein professioneller QR-Code-Generator: URL einfĂŒgen, den Modus Dynamischer QR-Code aktivieren, mit Ihrem Logo anpassen und fĂŒr den Druck als SVG exportieren. 2026 haben laut QR Code AI fast 90 % der Amerikaner mindestens einen QR-Code gescannt — die Frage ist also nicht, ob man QR-Codes nutzt, sondern wie man sie professionell, sicher und messbar macht.

    Das 3-Schritte-Framework: Benutzerdefinierte scannbare Links erstellen

    Wie Jessica Lau, Senior Content Specialist bei Zapier, sagt: „QR-Codes tapezieren praktisch die Welt, von der Speisekarte in Ihrem lokalen CafĂ© bis zu dem etwas herablassenden Flyer in Ihrem Fitnessstudio.“

    So macht man es richtig.

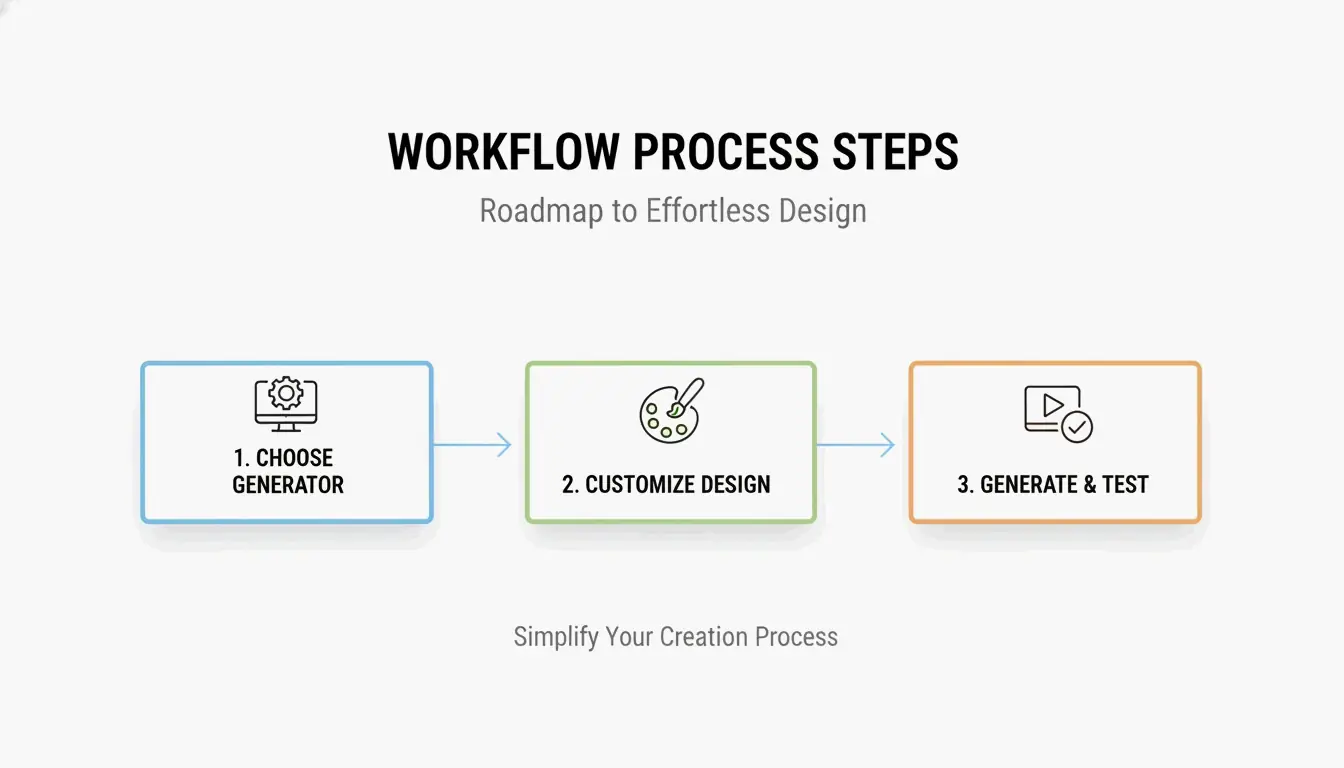
    3-Schritte-Prozess: AuswÀhlen, Anpassen, Generieren

    Schritt 1: WĂ€hlen Sie Ihren Generator

    Anwendungsfall Empfohlenes Tool Hauptmerkmal
    Unternehmensmarketing QR Code Generator von Bitly SOC-2-Type-II-KonformitÀt, Scan-Analysen
    Schneller persönlicher Link Chrome-integrierter Generator Schnell, kein Konto nötig
    KĂŒnstlerische / Marken-Codes QR Code AI KI-generierte Designs, Logo-Einbindung
    Budgetfreundlich Utlexia Kostenlos, hochkontrastiger Output

    FĂŒr professionelles Marketing wĂ€hlen Sie eine Plattform mit SOC-2-Type-II-Zertifizierung — das gewĂ€hrleistet verschlĂŒsselte Server und die Einhaltung des Datenschutzes.

    Schritt 2: Dynamischen Modus aktivieren und anpassen

    Nach der Eingabe Ihres Links (URL, PDF, WLAN-Zugangsdaten, vCard) schalten Sie auf Dynamischer QR-Code. Passen Sie dann an:

    • Markenfarben: Verwenden Sie Ihre Palette, aber behalten Sie hohen Kontrast — dunkle Vordergrundfarbe auf hellem Hintergrund fĂŒr zuverlĂ€ssiges Scannen bei jedem Licht
    • Logo-Platzierung: Setzen Sie Ihr Logo in die Mitte — Fehlerkorrektur hĂ€lt den Code funktionsfĂ€hig
    • Ruhezone: Lassen Sie um alle vier RĂ€nder weißen Raum; ohne ihn können Scanner die Code-Grenze nicht erkennen

    Schritt 3: Als SVG exportieren und testen

    Exportieren Sie fĂŒr jeden Druck in das SVG (Vektor-)Format. Anders als PNG/JPG bleibt SVG von der Visitenkarte bis zum Plakat perfekt scharf. FĂŒhren Sie vor dem Live-Gang immer einen Feldtest mit mindestens drei verschiedenen Telefonmodellen durch.

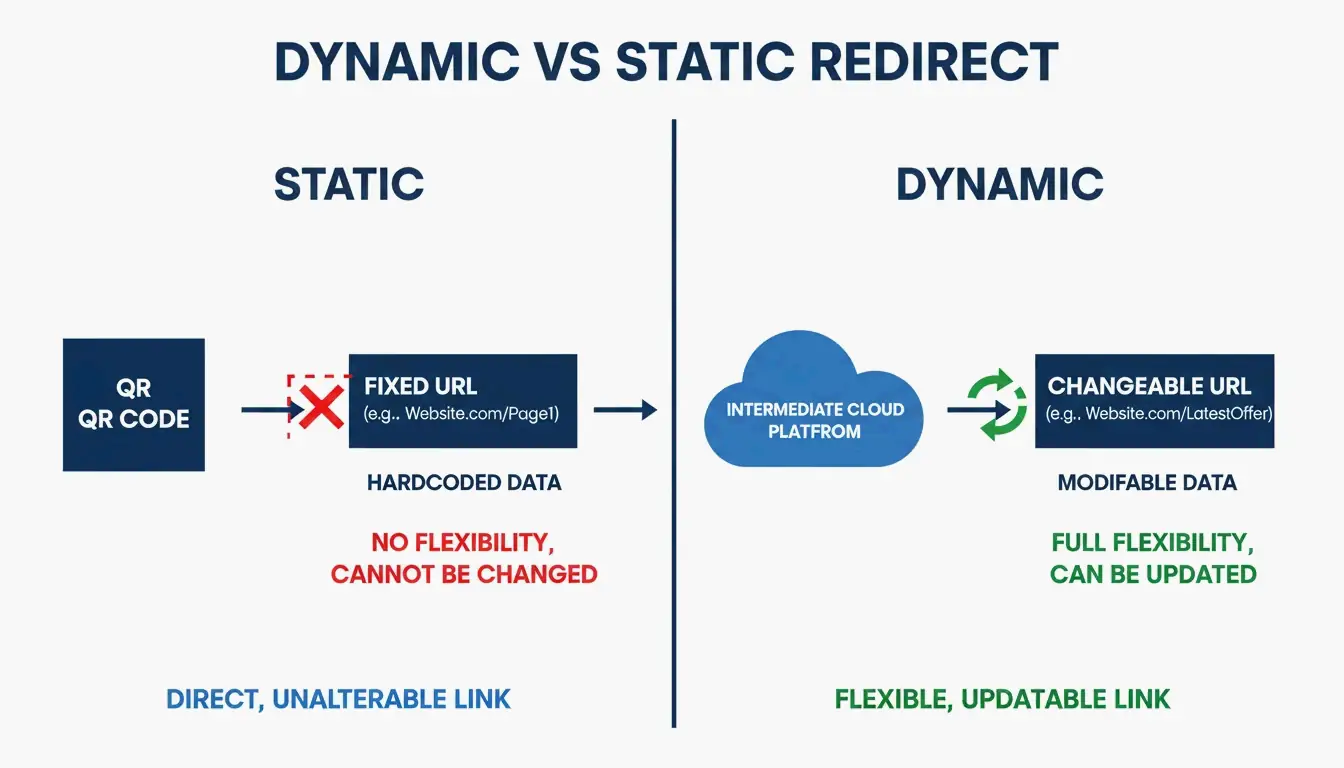
    Dynamische vs. statische QR-Codes: Warum dynamisch gewinnt

    Das ist die wichtigste Entscheidung im Prozess.

    Eigenschaft Statischer QR-Code Dynamischer QR-Code
    Daten Fest im Muster codiert Verwendet einen kurzen Redirect-Link
    Nach dem Druck Ă€nderbar Nein — Neudruck nötig Ja — URL im Dashboard Ă€ndern
    Scan-Analysen Nein Ja — Scans, Standorte, GerĂ€te
    Kosten Kostenlos Dienstabonnement erforderlich
    Ablauf Nie Bei Ablauf des Abos

    Dynamische Codes lösen das „Broken-Link“-Problem: Ändert sich Ihre URL, aktualisieren Sie den Redirect im Dashboard — ohne 5.000 Flyer neu zu drucken. Sie bieten auch Scan-Analysen: wie viele Menschen scannten, wo sie waren und welches GerĂ€t sie nutzten.

    Vergleich: Statisch (Direkt) vs. Dynamisch (Redirect)

    Fehlerkorrektur und SVG: Codes in der echten Welt zum Laufen bringen

    QR-Codes mĂŒssen auf gebogenen OberflĂ€chen, bei schwachem Licht und physischen SchĂ€den ĂŒberleben. Die Reed-Solomon-Fehlerkorrektur hĂ€lt den Code funktionsfĂ€hig, selbst wenn 30 % seiner OberflĂ€che zerkratzt oder bedeckt sind — das ermöglicht auch die Logo-Platzierung in der Mitte.

    Stufe Wiederherstellung Am besten fĂŒr
    L (Niedrig) 7 % DatenkapazitÀt maximieren
    M (Mittel) 15 % Allgemeines Marketing
    Q (Quartil) 25 % Außen / Industrie
    H (Hoch) 30 % Logo-Platzierung, raue Umgebungen

    Laut QR Code AI bringen Marken-Designs mit Logo 30 % mehr Scans als einfache Schwarz-Weiß-Muster. Verwenden Sie Stufe H, wenn Sie ein Logo einbetten.

    Sicherheit: Schutz vor Quishing (QR-Phishing)

    Mit der Verbreitung von QR-Codes wĂ€chst auch Quishing — Angreifer kleben legitime QR-Codes mit bösartigen Stickern zu, um Zugangsdaten zu stehlen.

    Schutz-Checkliste

    • SOC-2-Type-II-konforme Generatoren verwenden — verschlĂŒsselter Redirect schĂŒtzt Ihre Nutzer
    • Eigene Domains aktivieren — Nutzer sehen Ihren Markennamen in der URL-Vorschau, bevor die Seite lĂ€dt
    • Scan-Daten ĂŒberwachen — ungewöhnliche geografische Spitzen in den Analysen können auf einen kopierten Code hindeuten
    • URL-VerkĂŒrzer vermeiden, die Sie nicht kontrollieren — sie fĂŒgen eine nicht vertrauenswĂŒrdige Redirect-Ebene hinzu

    Das Taylor-Swift-Mural in Chicago — ein riesiger QR-Code, der ein Album ankĂŒndigte — zeigt, wie hochkarĂ€tige Kampagnen zu Zielen werden. Verwenden Sie eine eigene Domain, damit Nutzer das Ziel vor dem Scannen verifizieren können.

    Automatisierung im Maßstab: API- und Zapier-Integration

    Hunderte von Assets einzeln zu verwalten, skaliert nicht. Plattformen wie Bitly und Uniqode bieten API-Integrationen fĂŒr die Massengenerierung.

    Automatisierungs-Workflow

    1. Auslöser: Neues Produkt im CRM hinzugefĂŒgt oder Datei in Google Drive hochgeladen
    2. Aktion: Zapier generiert ĂŒber die API einen eindeutigen dynamischen QR-Code
    3. Ausgabe: Code wird automatisch zu Ihrem Scan-Analyse-Dashboard hinzugefĂŒgt

    Das eliminiert manuelle Erstellung und gibt Ihrem Team Echtzeit-Scan-Daten ĂŒber alle Assets.

    Fazit

    Einen professionellen QR-Code 2026 zu erstellen bedeutet, Design, FlexibilitĂ€t und Sicherheit auszubalancieren. Verwenden Sie einen dynamischen Code fĂŒr Bearbeitbarkeit und Analysen, behalten Sie hohen Kontrast mit einer korrekten Ruhezone, exportieren Sie fĂŒr den Druck als SVG und wĂ€hlen Sie einen SOC-2-konformen Generator. Marken-Designs mit Logo steigern die Scans um 30 % — aber fĂŒhren Sie vor dem Launch immer Feldtests mit mehreren GerĂ€ten durch.

    HĂ€ufig gestellte Fragen

    Laufen kostenlose QR-Codes irgendwann ab?

    Statische QR-Codes laufen nie ab — die Daten sind dauerhaft im Muster codiert. Dynamische QR-Codes können aufhören zu funktionieren, wenn die Testphase des Anbieters endet, das Konto gelöscht wird oder Scan-Limits erreicht sind. PrĂŒfen Sie die Servicebedingungen, wenn Sie langfristige dynamische Funktionen benötigen.

    Was ist die MindestgrĂ¶ĂŸe eines QR-Codes auf einer Visitenkarte?

    0,8 × 0,8 Zoll (2 × 2 cm) ist das empfohlene Minimum fĂŒr zuverlĂ€ssiges Smartphone-Scannen. Behalten Sie um alle RĂ€nder eine klare Ruhezone (leerer Abstand), damit Scanner die Code-Grenze erkennen können.

    Was ist der Unterschied zwischen PNG und SVG beim Drucken?

    PNG ist ein Rasterformat (Pixel) — es wird beim VergrĂ¶ĂŸern unscharf. SVG ist ein Vektorformat (mathematische Pfade) — es bleibt in jedem Maßstab perfekt scharf. Verwenden Sie fĂŒr den professionellen Druck auf Flyern, Plakaten und Verpackungen immer SVG.

  • WofĂŒr wird ein Barcode-Generator verwendet? Lager, Einzelhandel und Marketing 2026

    WofĂŒr wird ein Barcode-Generator verwendet? Lager, Einzelhandel und Marketing 2026

    Ein Barcode-Generator wandelt Text oder Zahlen in maschinenlesbare Muster fĂŒr Lagerverwaltung, Anlagenverfolgung und EinzelhandelsverkĂ€ufe um. Im Jahr 2026 ĂŒberbrĂŒcken diese Tools die Offline-Online-LĂŒcke mit UPC-A/EAN-13 fĂŒr den globalen Einzelhandel, Code 128 fĂŒr interne Logistik und dynamischen QR-Codes fĂŒr Mobile-Marketing mit Echtzeit-Scan-Analyse.

    Wie KODE.link es ausdrĂŒckt: Ein zuverlĂ€ssiger Barcode-Generator ist kein Luxus mehr — er ist eine Infrastruktur, die physische Artikel mit digitalen Datenbanken verbindet.

    Lagerverwaltung: Code 128 fĂŒrs Lager

    FĂŒr interne Logistik ist Code 128 das Barcode-Format der Wahl. Er unterstĂŒtzt alle 128 ASCII-Zeichen und packt hohe Datendichte in ein schmales Etikett — ideal fĂŒr LagerkĂ€sten, Versandpaletten und TeilekĂ€sten.

    Wasp Barcode stellt fest, dass Code 128 mit Standard-1D-Scannern funktioniert und die Fehlerraten laut Wikipedia auf etwa einen Fehler pro mehreren Millionen Zeichen senkt.

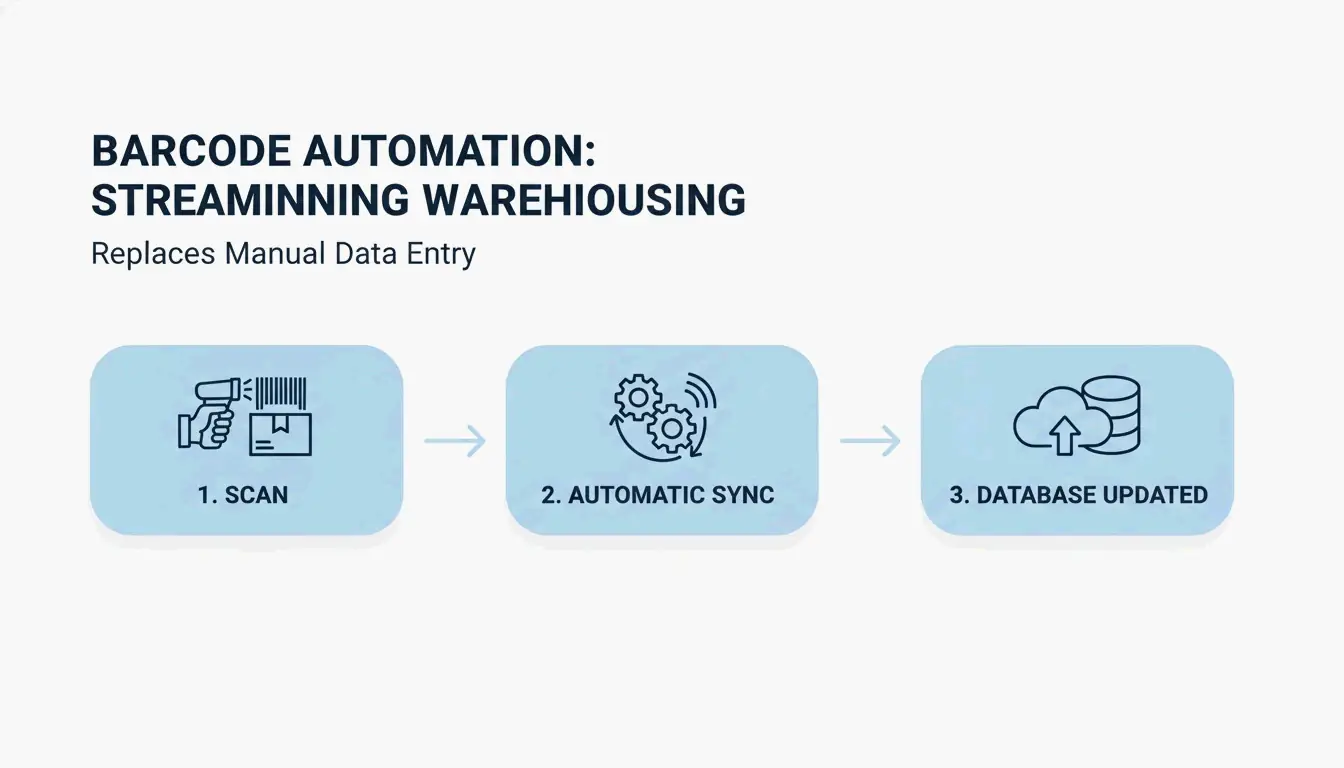
    Lagerverwaltungs-Workflow mit Scan-zum-Aktualisieren

    Anlagenverfolgung: Lebenszyklusmanagement

    Barcode-Generatoren verfolgen auch Anlagevermögen — Laptops, Elektrowerkzeuge, Maschinen. Indem jeder Artikel einen eindeutigen Barcode erhĂ€lt, können Unternehmen:

    • GerĂ€te bestimmten Mitarbeitern oder Baustellen zuweisen
    • Ausgabe-/RĂŒckgabeereignisse in Echtzeit protokollieren
    • WartungsplĂ€ne verfolgen und Artikel markieren, bevor sie ausfallen

    Wasp Barcode betont, dass der echte Wert darin entsteht, die Codes mit Tracking-Software zu verbinden — was jedem Anlagegut eine vollstĂ€ndige digitale Historie ohne Papierkram gibt.

    Einzelhandel: UPC-A- und EAN-13-Standards

    FĂŒr in Nordamerika verkaufte Produkte benötigen Sie UPC-A-Codes (12-stellig). Weltweit ist EAN-13 (13-stellig) der Standard. Beide folgen GS1-Standards und stellen sicher, dass ein in einem GeschĂ€ft gescanntes Produkt weltweit erkannt wird.

    Der erste UPC-Scan fand im Juni 1974 im Marsh-Supermarkt statt — eine Packung Wrigley’s Juicy Fruit Kaugummi. Heute ist GS1-KonformitĂ€t eine nicht verhandelbare Voraussetzung fĂŒr jede Marke, die in die Regale des Einzelhandels will.

    Druck-Best-Practices: DPI, Kontrast und Ruhezonen

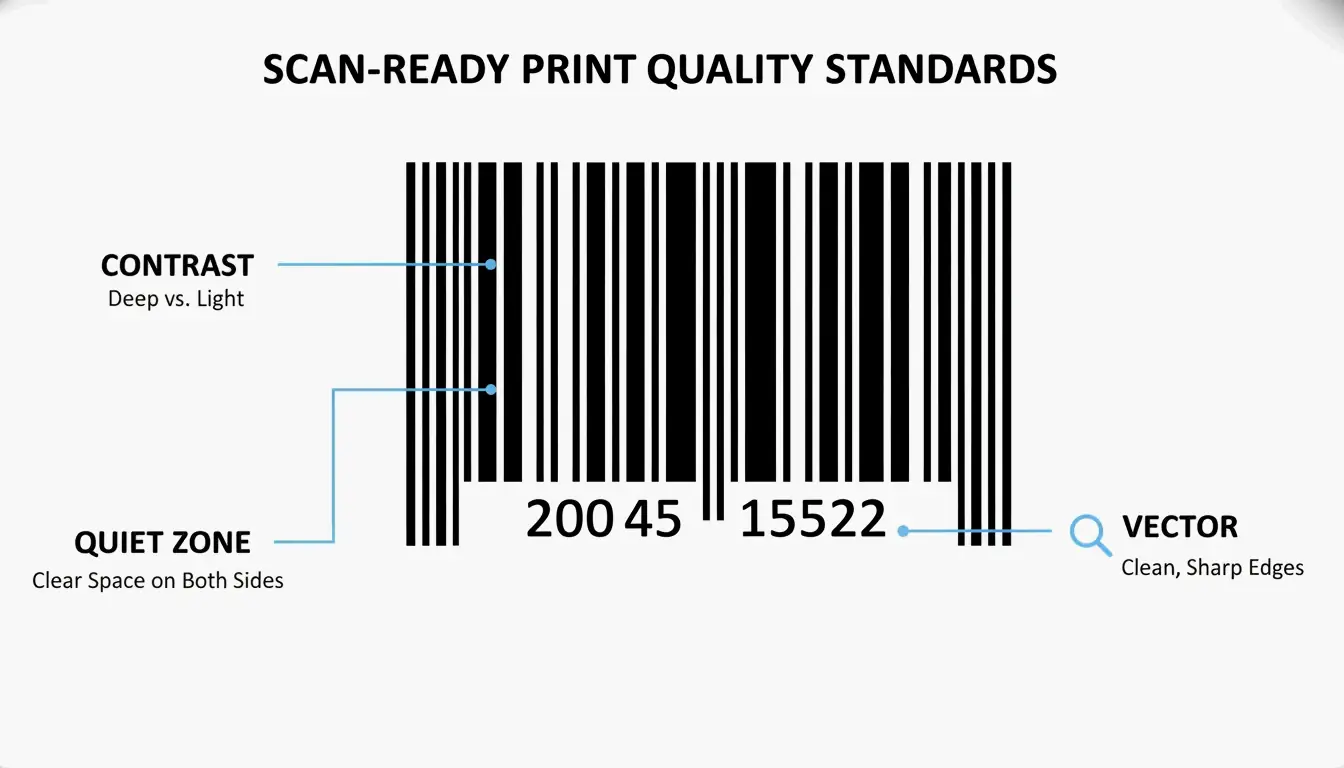
    Ein Barcode ist nur nĂŒtzlich, wenn er scannt.CodeItBro empfiehlt, Codes als SVG (Scalable Vector Graphics) zu exportieren — sie bleiben in jeder GrĂ¶ĂŸe scharf.

    Anforderung | Warum sie wichtig ist
    —|—|
    Hoher Kontrast | Die Balken mĂŒssen deutlich dunkler als der Hintergrund sein, damit der Laser sie sieht
    Ruhezonen | Leere RĂ€nder auf beiden Seiten sagen dem Scanner, wo der Code beginnt und endet
    Vektorausgabe | SVG bleibt in jeder GrĂ¶ĂŸe scharf; PNG funktioniert nur bei einfachen Etiketten

    Drei SchlĂŒsselelemente der Scanbarkeit von Barcodes: Kontrast, Ruhezone, Vektorformat

    QR-Code vs. Barcode: Welchen brauchen Sie?

    Die Wahl hÀngt von DatenkapazitÀt und Scan-Kontext ab:

    Merkmal Linearer Barcode (1D) QR-Code (2D)
    DatenkapazitÀt ~20 Zeichen Bis zu 7.089 numerische Zeichen
    Scanner 1D-Laserscanner Smartphone-Kamera / 2D-Imager
    Haupteinsatz Lager & Einzelhandel (UPC/EAN) Marketing, URLs, komplexe Daten
    Anpassbarkeit Begrenzt Hoch — Farben, Logos, Formen
    Fehlerkorrektur Minimal Bis zu 30 % Schadens toleranz

    Quelle: QRStuff

    Dynamische QR-Codes fĂŒrs Marketing

    Dynamische QR-Codes sind zum Marketing-Standard geworden. Anders als statische Codes (Daten festgeschrieben) nutzen dynamische Codes einen Redirect-Link — Sie können also die Ziel-URL Ă€ndern, selbst nachdem Sie 5.000 Flyer gedruckt haben. Tools wie QR Code Generator liefern außerdem Scan-Analysen, die zeigen, wann und wo Menschen scannen.

    KI-generierte QR-Codes: scannbare Kunst im Jahr 2026

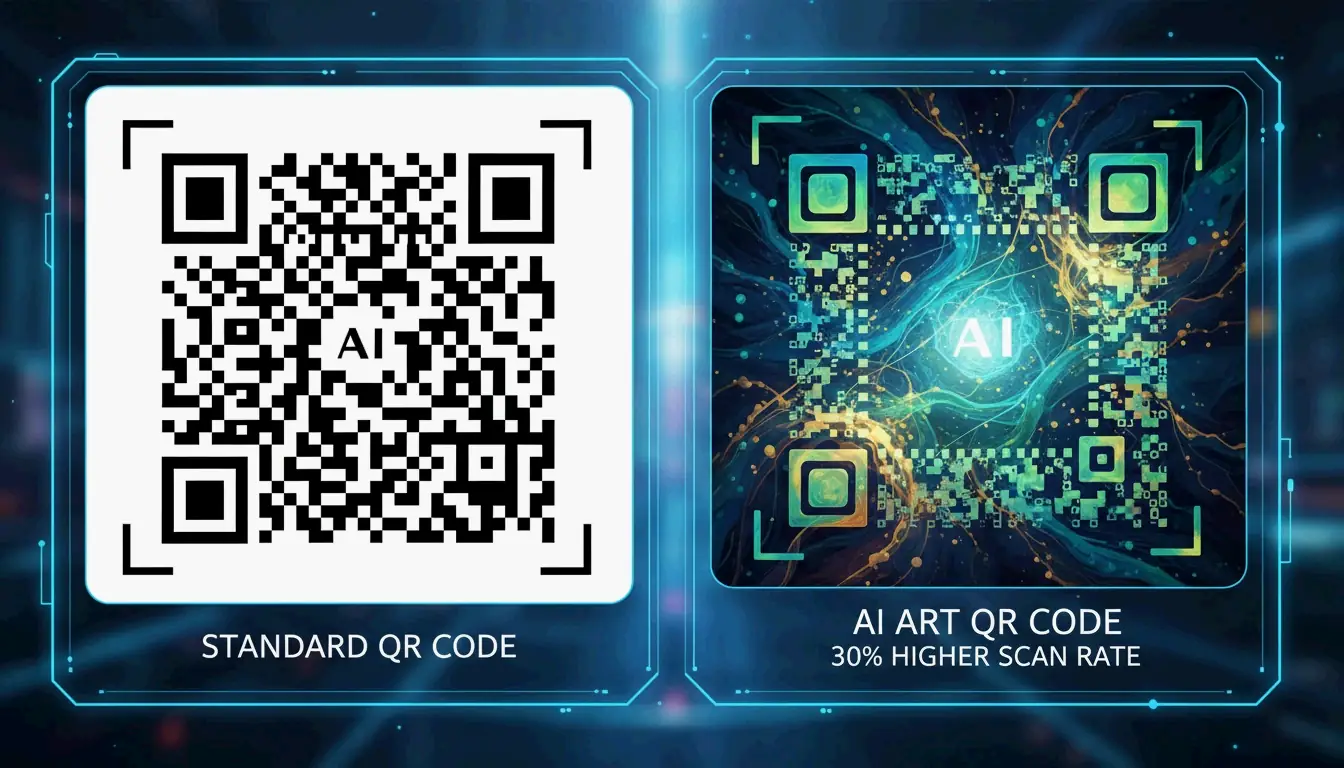
    Bis 2026 haben Barcode-Generatoren Schwarz-Weiß-Quadrate hinter sich gelassen. Generative KI verwebt Markenlogos und kĂŒnstlerische Muster direkt in funktionale QR-Codes — und macht den Code zum Teil des Designs statt zu einem visuellen Nachgedanken.

    Daten von QR Code AI zeigen, dass gebrandete kĂŒnstlerische QR-Codes im Schnitt 30 % mehr Scans erhalten als traditionelle. Dieser Engagement-Schub ist Teil von GEO (Generative Engine Optimization) und sendet hochwertige Verkehrssignale an digitale Plattformen zurĂŒck.

    Visueller Vergleich zwischen einem kĂŒnstlerischen KI-QR-Code und einem traditionellen QR-Code

    Fazit

    Ein Barcode-Generator ist die BrĂŒcke zwischen physischen Produkten und digitalen Daten — egal, ob Sie mit Code 128 ein Lager ordnen, mit UPC-A Einzelhandelsanforderungen erfĂŒllen oder Kampagnen mit KI-designten QR-Codes fahren. WĂ€hlen Sie das Format, das zu Ihrem Ziel passt, exportieren Sie als SVG, und jeder Scan funktioniert beim ersten Mal.

    HĂ€ufig gestellte Fragen

    Verfallen QR-Codes oder haben sie ein Scan-Limit?

    Statische QR-Codes verfallen nie — die Daten sind im Muster eingebettet. Dynamische QR-Codes hĂ€ngen von einem Dienstleister ab; wenn die Weiterleitung deaktiviert wird oder Ihr Abonnement endet, funktioniert der Code nicht mehr. Die meisten professionellen Generatoren wie QR Code Generator bieten unbegrenzte Scans bei GeschĂ€ftskonten.

    Wie ist die MindestgrĂ¶ĂŸe eines gedruckten Barcodes?

    Ein Standard-UPC-A sollte etwa 1,46″×1,02″ groß sein. Das Minimum fĂŒr den Einzelhandel liegt bei etwa 80 % davon (ca. 0,8″ breit). Bei QR-Codes empfiehlt QR Code Generator mindestens 2×2 cm (0,8″×0,8″) fĂŒr zuverlĂ€ssiges Smartphone-Scannen.

    Kann ich das Ziel eines QR-Codes nach dem Druck Àndern?

    Nur bei einem dynamischen QR-Code. Statische Codes haben die Daten fest eingebaut — Ă€ndert sich die URL, brauchen Sie einen neuen Code. Dynamische Codes nutzen einen kurzen Redirect-Link, den Sie jederzeit aus Ihrem Dashboard aktualisieren können, auch nach dem Druck.

  • Die Geschichte des Barcodes: vom Morsecode im Sand bis GS1 Sunrise 2027

    Die Geschichte des Barcodes: vom Morsecode im Sand bis GS1 Sunrise 2027

    Der Barcode begann 1948, als Norman Joseph Woodland vom Morsecode inspirierte Linien in den Floridasand zeichnete, wurde 1952 patentiert und zum globalen Einzelhandelsstandard, als IBMs UPC 1973 auf den Markt kam. Heute, mit ĂŒber 10 Milliarden Scans pro Tag weltweit, rast die Branche auf GS1 Sunrise 2027 zu — den vollstĂ€ndigen Übergang von 1D-Barcodes zu 2D-QR-Codes.

    Hier ist die ganze Geschichte, von diesem Strand in Miami bis zu den Scannern bei Tesco.

    Der Sunrise 2027: Warum HĂ€ndler jetzt auf 2D-Codes umsteigen

    Der grĂ¶ĂŸte Wandel seit den 1970er Jahren ist im Gange. Klassische 1D-Barcodes identifizieren ein Produkt und seinen Hersteller. Moderne 2D-QR-Codes können Haltbarkeitsdaten, Chargennummern, Allergeninformationen und Weblinks speichern — alles in einem einzigen Scan.

    Merkmal 1D-Barcode (UPC) 2D-QR-Code
    DatenkapazitĂ€t 20–80 numerische Zeichen Bis zu 4.000 Zeichen
    Inhaltstypen Produkt-ID + Hersteller URLs, Chargennummern, Daten, Bilder
    Fehlerkorrektur Minimal Bis zu 30 % Schadens toleranz
    Smartphone-scannbar EingeschrĂ€nkt Native UnterstĂŒtzung auf allen modernen Handys

    Tesco wurde der erste britische Supermarkt, der den Wechsel vollzog. Im April 2026 begann das Unternehmen, Barcodes auf WĂŒrstchen der Eigenmarke und Frischeprodukten durch QR-Codes zu ersetzen. Kunden können eine Packung mit dem Handy scannen, um Allergene zu prĂŒfen oder Rezepte zu finden. Der Laden erhĂ€lt ein besseres Tracking von Haltbarkeitsdaten, um Lebensmittelverschwendung zu reduzieren.

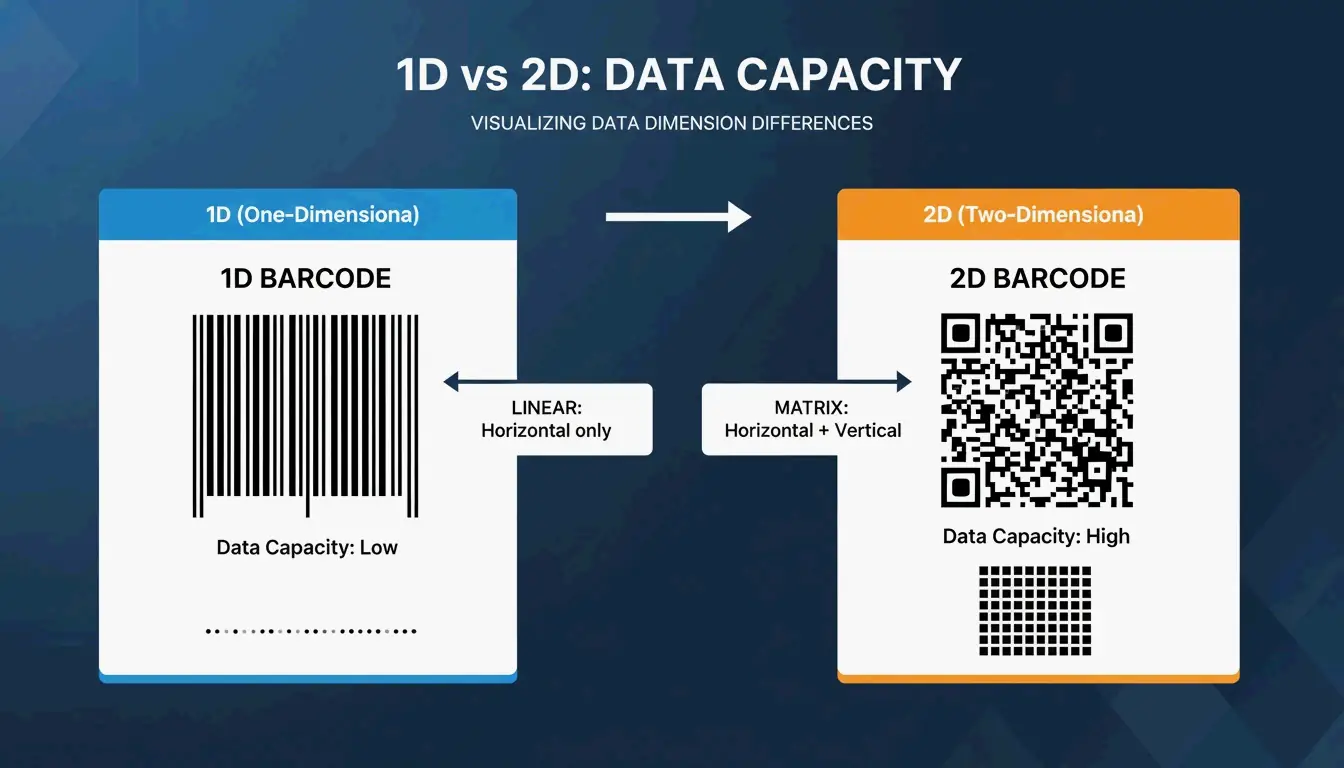
    Minimalistischer Vergleich zwischen 1D-Barcodes und 2D-Barcodes (QR-Codes): DatenkapazitÀt und Abmessungen

    Der Ursprung: Morsecode im Sand (1948)

    Die Geschichte beginnt am Drexel Institute of Technology in Philadelphia. Ein LebensmittelgeschĂ€ftsfĂŒhrer bat einen Dekan, den Checkout zu automatisieren. Bernard Silver belauschte das GesprĂ€ch und erzĂ€hlte es seinem Freund Norman Joseph Woodland. Woodland wurde besessen davon, das Problem zu lösen.

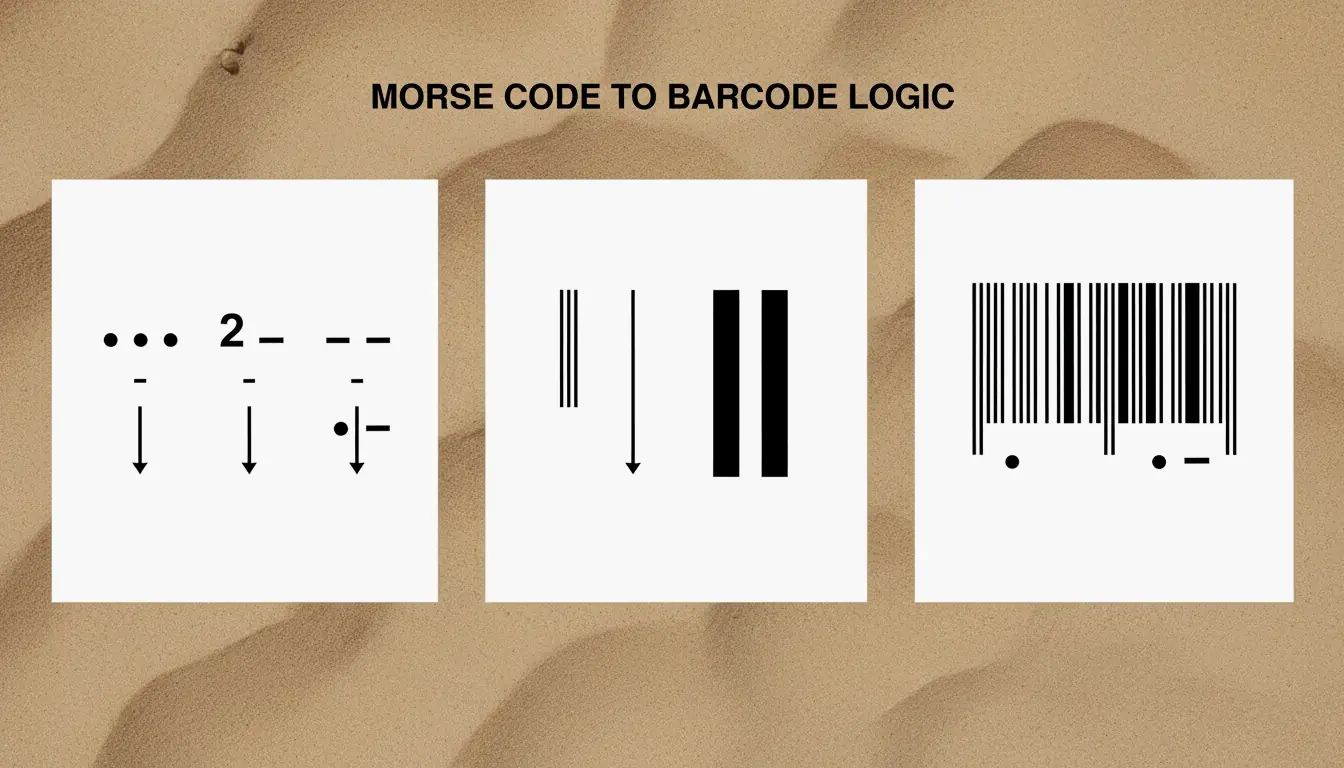
    Der Durchbruch kam an einem Strand in Miami. Woodland, ein ehemaliger Pfadfinder, dachte ĂŒber den Morsecode nach. Er drĂŒckte seine Finger in den Sand, zeichnete Punkte und Striche und zog sie dann nach unten, um vertikale Linien unterschiedlicher Breite zu schaffen.

    „Ich habe die Punkte und Striche einfach nach unten verlĂ€ngert und daraus schmale und breite Linien gemacht.“ — Norman Joseph Woodland, zitiert in Wikipedia

    Minimalistische Darstellung: wie Morsecode „Punkte und Striche" sich dehnen und in einen Barcode verwandeln

    Die Zielscheibenbauweise (Patent von 1952)

    Das Patent von Woodland und Silver aus dem Jahr 1952 (US-Patent 2.612.994) verwendete eine „Zielscheibe“ — konzentrische Kreise, die aus jedem Winkel gescannt werden konnten. Das Problem: Hochgeschwindigkeitsdrucker verschmierten die Tinte. Ein verschmierter Kreis wurde unlesbar. Eine verschmierte Linie wurde nur höher, aber ihre datentragende Breite blieb gleich. Lineare Designs setzten sich durch.

    IBM, George Laurer und der UPC-Standard (1973)

    Trotz des Patents staubte die Barcode-Technologie zwei Jahrzehnte lang. Die Lichter und Computer, die zum Lesen der Codes nötig waren, waren fĂŒr die meisten GeschĂ€fte zu teuer.

    Anfang der 1970er grĂŒndete die Lebensmittelbranche einen Ausschuss zur Auswahl eines Standards. RCA drĂ€ngte auf die Zielscheibe. IBM hatte eine andere Idee — George Laurer, der bei IBM neben Woodland arbeitete, verfeinerte das lineare Konzept zum Universal Product Code (UPC).

    Am 3. April 1973 wÀhlte der Ausschuss Laurers Design. Es war leichter zu drucken und zuverlÀssiger in der chaotischen, schnelllebigen Umgebung eines echten Supermarkts.

    Der erste Scan: 26. Juni 1974, 8:01 Uhr

    Im Marsh-Supermarkt in Troy, Ohio, scannte Kassiererin Sharon Buchanan eine 10er-Packung Wrigley’s Juicy Fruit Kaugummi. Er kostete 69 Cent. Dieses einzelne „Piep“ bewies, dass das System kleine, alltĂ€gliche Artikel bewĂ€ltigen konnte — und verĂ€nderte den Einzelhandel fĂŒr immer. Diese Kaugummipackung befindet sich heute in der Smithsonian Institution.

    1D vs. 2D: DatenkapazitÀt und reale Auswirkung

    Die LĂŒcke zwischen 1D- und 2D-Codes ist nicht subtil.

    • 1D-Barcodes (wie UPC) sind linear. Sie speichern 20–80 numerische Zeichen — genug fĂŒr eine Produkt-ID.
    • 2D-QR-Codes, 1994 von Denso Wave fĂŒr Toyotas Lieferkette erfunden, nutzen ein Rastermuster. Sie speichern bis zu 4.000 Zeichen, darunter URLs und strukturierte Daten.

    Die QR-Code-Nutzung in den USA erreichte bis 2022 89 Millionen Menschen und steigt weiter. Wie Peter Draper von Tesco erklĂ€rt: „Der Umstieg auf QR-Codes wird uns helfen, Lebensmittelverschwendung zu reduzieren, die Lagerverwaltung zu verbessern und neue digitale Vorteile fĂŒr unsere Kunden zu erschließen.“

    GS1 und globale Standards im Jahr 2026

    GS1 verwaltet die Global Trade Item Numbers (GTINs) — und stellt sicher, dass ein in London gescannter Barcode dasselbe bedeutet wie in New York. Laut GS1-Daten hat diese Standardisierung geholfen, den Markt fĂŒr die Lagerverfolgung auf schĂ€tzungsweise 4,5 Milliarden Dollar bis 2033 anwachsen zu lassen.

    Im Jahr 2026 lösen diese Standards auch Umweltprobleme. Da 2D-Codes Haltbarkeitsdaten enthalten, können SupermĂ€rkte Lebensmittel, die kurz vor dem Ablauf steht, automatisch reduzieren und so Verschwendung verringern. Indem Barcodes mit dem Internet der Dinge (IoT) verbunden werden, bleibt diese 75 Jahre alte Erfindung das RĂŒckgrat des Welthandels.

    Fazit

    Der Barcode hat eine Reise von einer Morsecode-Skizze im Floridasand zu einem System zurĂŒckgelegt, das 10 Milliarden Scans pro Tag bewĂ€ltigt. Vom ursprĂŒnglichen Zielscheiben-Patent von Woodland und Silver, ĂŒber Laurers UPC-Standardisierung, bis hin zum von GS1 Sunrise 2027 vorangetriebenen QR-Code-Übergang — die Technologie passt sich stets an.

    Unternehmen sollten ihre Scanner und Verpackungen jetzt prĂŒfen. Die Frist von 2027 bedeutet, dass jedes Kassensystem 2D-Codes lesen muss, und dass jedes Produkt eine reichhaltigere digitale Geschichte tragen wird.

    HĂ€ufig gestellte Fragen

    Wer hat den allerersten Barcode gescannt?

    Sharon Buchanan, eine Kassiererin im Marsh-Supermarkt in Troy, Ohio. Das Ereignis fand am 26. Juni 1974 um 8:01 Uhr statt. Sie scannte eine 10er-Packung Wrigley’s Juicy Fruit Kaugummi (Preis: 69 Cent), die heute in der Smithsonian Institution ausgestellt ist.

    Warum wechselt die Einzelhandelsbranche bis 2027 von 1D-Barcodes zu QR-Codes?

    Die Initiative GS1 Sunrise 2027 verlangt, dass alle Kassensysteme 2D-Barcodes lesen. QR-Codes enthalten weit mehr Daten als 1D-Codes — Haltbarkeitsdaten, Chargennummern, Nachhaltigkeitsinformationen — was die Lebensmittelsicherheit verbessert, Abfall reduziert und auf Smartphones basierende Kundenbindung ermöglicht.

    Wie hat der Morsecode das ursprĂŒngliche Barcode-Design beeinflusst?

    Norman Joseph Woodland, ein im Morsecode versierter Pfadfinder, saß 1948 an einem Strand in Miami und dachte darĂŒber nach, wie man Daten visuell darstellen kann. Er zeichnete Punkte und Striche in den Sand und zog sie dann nach unten, um vertikale Linien unterschiedlicher Breite zu schaffen. Diese visuelle Übersetzung des Morsecodes wurde zur grundlegenden Logik aller linearen Barcodes.